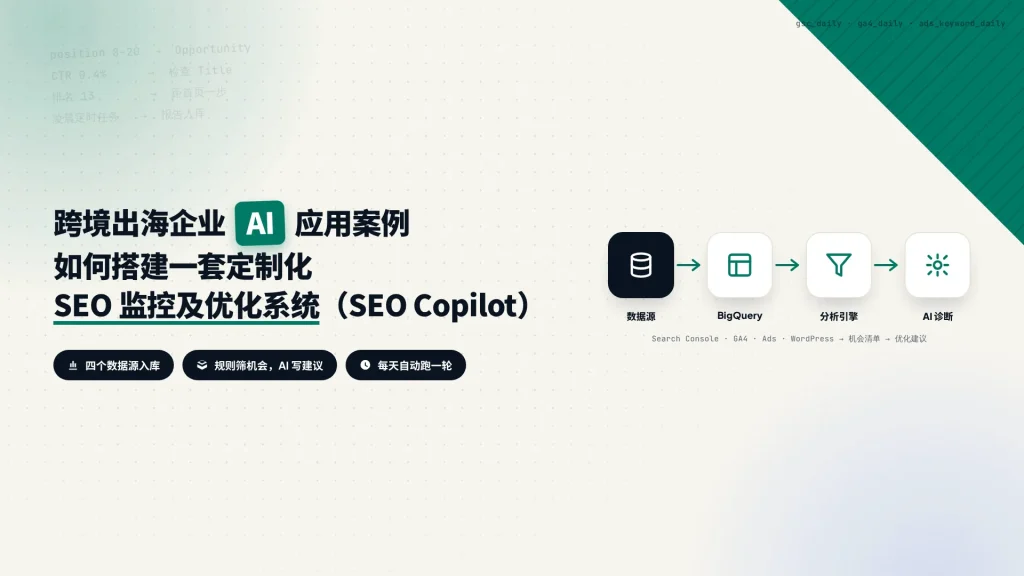
这篇文章记录一套跨境企业自建 SEO Copilot 的过程:从明确 SEO 问题、准备基础设施,到让 AI Agent 设计系统架构并接入 Search Console、GA4、Google Ads 和 WordPress 数据,最后输出可执行建议。文末附有完整开发 SOP,可供参考,也可直接作为 Agent 开发指引。
为什么要自己搭建一套 SEO 工具?
市面上并不缺 SEO 工具。Ahrefs、Semrush、Screaming Frog,以及近年来大量出现的 AI SEO 助手,都可以帮助企业完成关键词研究、竞争分析、网站审计等工作。
但是,在长期运营跨境企业网站的过程中,我逐渐发现一个问题:通用 SEO 工具解决的是“行业层面的 SEO 分析”,而企业真正需要的是“基于自身业务数据的 SEO 决策系统”。
例如,Semrush 可以告诉你某个关键词在全球范围内的搜索量是多少、哪些竞争对手正在排名、某个网站可能获得多少自然流量,但是它无法回答企业每天真正关心的问题:
- 为什么某个产品页面最近曝光量增长,但是点击率持续下降?
- 哪些关键词已经进入 Google 第二页,只需要进一步优化就有机会进入首页?
- 网站中哪些页面正在竞争同一个关键词?
- 上个月修改的内容,到底有没有带来排名和转化提升?
- 哪些页面获得大量自然流量,却没有产生任何商业价值?
这些问题的答案,其实并不在第三方 SEO SaaS 平台中,它们隐藏在企业自己的数据资产里:Google Search Console、Google Analytics 4、Google Ads、WordPress 内容数据库,以及企业自己的产品和业务信息。这些数据对于每个企业都是独一无二的。
对于一个 SEO 软件平台来说,“某关键词全球搜索量是多少?”是一个通用问题。但是对于一家跨境 B2B 企业来说,“这个关键词是否值得投入内容资源?”需要结合当前排名、页面类型、产品匹配度、用户行为和转化数据,这些信息只有企业自己拥有。
因此,我开始思考:如果能够把这些分散的数据连接起来,再利用 AI Agent 自动分析,是不是可以打造一套真正属于企业自己的 SEO Copilot?
过去,实现这个想法并不容易,因为你需要同时具备 SEO 专业知识、数据分析能力、数据库能力、后端开发能力、前端开发能力和服务器部署能力。对于大多数 SEO 人员、市场人员甚至企业负责人来说,这几乎是不可能完成的事情。最终,大部分企业只能选择定期导出 Excel、人工整理数据、凭经验判断优化方向。
但是随着 AI Coding Agent 的出现,这件事情正在发生变化。现在,一个懂业务的人,不一定需要成为专业程序员,也可以参与复杂系统开发。你需要负责定义业务目标、梳理数据来源、判断分析结果是否符合业务逻辑,而 Agent 可以帮助完成数据处理、后端开发、前端界面、自动化流程和系统部署。
本文将完整介绍如何从 0 到 1,搭建一套属于跨境企业自己的 SEO Copilot。它不是一个简单的数据 Dashboard,而是一套能够自动采集 SEO 数据、分析网站状态、发现优化机会、生成行动建议、持续追踪优化效果的 AI 驱动 SEO 系统。
NOTE 说明
为了保护企业数据隐私,本文涉及的网站名称、关键词、页面 URL 和业务数据均进行了泛化处理,但整体技术架构和开发流程与真实项目保持一致。
在开发之前,先明确 SEO Copilot 要解决什么问题
很多人在开发 AI 工具时,会犯一个常见错误:打开 Claude Code 或 Codex,然后输入“帮我开发一个 SEO 工具。”随后 Agent 开始生成代码,几分钟后,一个拥有漂亮界面的 Dashboard 就出现了。
但是问题是:它可能并没有真正解决 SEO 工作中的核心问题。因为一个 SEO 系统最重要的不是界面,而是它是否能够帮助企业做出正确决策。因此,在开始开发之前,需要先定义这套 SEO Copilot 到底需要解决哪些问题。
1. 网站整体 SEO 状态监控
第一个需求是了解网站整体健康状态。系统需要持续监控自然搜索曝光趋势、点击趋势、CTR 变化、平均排名变化和自然搜索转化趋势,数据来源是 Google Search Console 和 Google Analytics 4。
最终目标不是展示更多数字,而是回答:“过去一段时间,网站 SEO 表现是在改善还是恶化?”
2. 自动发现关键词增长机会
SEO 中最值得关注的关键词,通常不是完全没有排名的新关键词,而是已经接近首页、但是还差一步的关键词。
例如某个商业关键词:
Example Keyword
Average Position: 13
过去 90 天 Impression: 15000
过去 90 天 Click: 200
这意味着 Google 已经认可这个页面与搜索意图相关。相比从零开始竞争新关键词,这类关键词通常拥有更高优化价值。因此 SEO Copilot 需要自动发现排名 8-20 名的关键词、持续获得曝光的关键词、与业务相关的关键词,并生成“建议重点优化”的任务列表。
3. 找出页面级 SEO 问题
关键词只是入口,最终影响 SEO 效果的是页面。系统需要识别三类问题页面。
高曝光低点击页面
例如一个页面曝光非常高、排名不错,但是 CTR 很低。可能原因是 Title 不够吸引、Meta Description 不匹配、搜索意图理解错误。
有流量但无转化页面
例如某页面每月有大量自然访问,用户停留也正常,但是没有产生任何业务行为,可能需要调整 CTA、优化页面结构、增加产品关联内容。
薄内容页面
系统需要识别内容过短、缺少主题覆盖、与搜索意图不匹配的页面。
4. 发现关键词内部竞争问题
很多企业网站都会遇到多个页面竞争同一个关键词的情况。例如网站同时存在产品页面、博客文章和资源页面,都在尝试排名 Example Keyword。结果是 Google 不确定哪个页面才是主要答案,这就是 Keyword Cannibalization(关键词内耗)。
SEO Copilot 需要自动分析哪些关键词对应多个 URL、哪个页面表现最好、是否需要合并内容、是否需要调整页面定位。
5. 自动生成 SEO 优化建议
发现问题不是最终目的,真正有价值的是告诉运营人员下一步应该做什么。
例如系统发现:
页面:/example-product-guide/
关键词:Example Keyword
排名:12
CTR: 0.8%
AI 输出:
- 建议优化 Title,提高点击吸引力
- 增加相关问题 FAQ
- 补充案例和应用场景
- 增加内部链接
这样 SEO 就从“人工分析”变成“系统提供优化任务”。
6. 建立 SEO 优化闭环
传统 SEO 流程是发现问题、修改页面、等待结果,最大的问题在于没人记录为什么修改、修改后是否有效。SEO Copilot 希望建立的链路是:
SEO 优化闭环
发现问题
→
生成建议
→
人工执行优化
→
记录修改时间
→
自动评估效果
最终形成数据驱动的 SEO 优化循环。
开发 SEO Copilot 需要哪些基础设施?
确定目标后,下一步是准备开发环境。整个系统主要由 AI Agent、数据源、数据仓库和服务器环境组成。
1. AI Coding Agent
本项目使用 AI Coding Agent 作为主要开发工具,例如 Claude Code 和 OpenAI Codex。前者的安装步骤在这篇 如何安装 Claude Code:macOS、Windows、Linux 完整准备清单 里,Codex 可以看 如何安装 Codex CLI。它承担项目规划、代码生成、数据结构设计、Debug 和部署辅助。
但是需要注意:Agent 并不是自动开发机器。它最大的价值是将你的业务想法快速转化为可运行系统。你的角色负责“做什么”,Agent 负责“怎么实现”。如果还没有订阅,可以看这篇 无需信用卡,也可以订阅 ChatGPT 和 Claude Code。
2. Google Search Console
Google Search Console 是 Google 官方提供的网站搜索分析工具,它提供用户搜索关键词、展现次数、点击次数、CTR 和平均排名。对于 SEO 来说,这是最核心的一手数据。
但是 Search Console 网页端主要用于人工查看,如果想长期分析,需要将数据导入 BigQuery。站点接入可以看这篇 如何将网站连接到 Google Search Console 并提交站点地图,数据导出的方法在这篇 如何把 Google Search Console 数据导出到 BigQuery。
3. Google Analytics 4
GA4 负责提供用户进入网站之后发生了什么,包括 Session、用户来源、页面行为和转化事件。简单理解:GSC 告诉你用户如何找到网站,GA4 告诉你用户来到网站之后是否产生价值。
一样是先把数据流建好,具体步骤在这篇 如何为你的网站创建 GA4 数据流;再把事件数据导出到 BigQuery,方法看这篇 如何把 GA4 数据导出到 BigQuery。
4. Google Ads
Google Ads 数据用于补充商业关键词分析,因为广告投放数据能够反映哪些关键词具有商业价值。结合自然排名数据,可以帮助企业发现哪些付费关键词值得长期布局 SEO。导出方式在这篇 如何把 Google Ads 数据导出到 BigQuery。
5. Google BigQuery
BigQuery 是整个 SEO Copilot 的数据基础。简单理解:Google Search Console、GA4、Google Ads 负责产生数据,BigQuery 负责保存和分析数据。系统整体流程是:
从数据源到 SEO 建议
Google Search Console
Google Analytics 4
Google Ads
Google BigQuery
保存和管理全部 SEO 数据
↓
SEO Analysis Engine
按规则筛出机会与问题
↓
AI Agent
解释原因,生成优化建议
↓
SEO Recommendation
给运营人员的行动清单
为什么不用 Excel?因为 SEO 数据具有长周期、多来源、高频更新的特点,需要一个真正的数据仓库。
数据都导出到 BigQuery 之后,还需要让 Agent 自己能读这些数据,因此要为它单独创建一个 Service Account 并分配查询权限,具体步骤在这篇 如何创建 AI Agent 使用的 BigQuery Service Account 里。
6. SEO Copilot 还需要额外准备的数据资产
Google Search Console、Google Analytics 4、Google Ads 和 BigQuery 这四项解决的是同一件事,网站自身发生了什么。但一个面向企业 SEO 决策的 Copilot,还需要另外三类数据:企业自己的目标关键词、竞争对手的关键词表现,以及网站当前的内容资产。SEO 决策不只要知道自己表现如何,还要知道市场正在发生什么,以及网站手上已经有哪些内容。
三类容易忽略的数据资产
Google Ads 关键词结构
经过业务验证的商业词
竞品关键词数据
SEMrush 等平台的排名与流量
网站内容快照
WordPress REST API 定时抓取
Google BigQuery
与原有数据放在同一层做关联
Google Ads 的广告数据不只是用来判断广告效果,它同时是企业商业关键词的来源。一个企业长期投放某几个关键词,通常说明这些词经过业务验证,能带来询盘或订单。系统把投放关键词、广告组结构、点击数据和转化数据,与自然搜索数据放在一起比对,能看出一些单独看广告或单独看自然搜索都看不出来的机会。比如某个关键词的广告持续产生转化,自然排名却长期停在第二页,系统就会把它标成值得长期做 SEO 布局的词。
需要留意的是,Google Ads 导入 BigQuery 的数据偏向广告效果分析,而企业主动维护的广告组关键词结构是另外一份东西,更适合单独存成一个数据源。两份数据合起来,系统才会同时知道哪些关键词有流量,哪些关键词有商业价值。
竞争对手的关键词数据来自外部 SEO 数据平台,比如 SEMrush,可以定期把竞品的排名关键词、对应页面、排名变化和预估流量同步进来。这类数据回答的是自己的看板回答不了的问题:竞争对手最近拿到了哪些新机会,哪些主题正在变成行业趋势,哪些词值得提前布局。如果平台提供 API,同步可以交给定时任务,不用人工导出。想把这块成本压下来,KWFinder 这类轻量工具也能覆盖基础的关键词数据。
第三类是网站自己的内容快照。排名数据能说明页面被搜到了,说明不了页面上写了什么,所以系统要定期把网站内容抓下来存档。WordPress 站点可以直接调用 REST API,取出页面、文章、产品和分类信息,保存 URL、Title、Meta 信息、正文内容、更新时间和内容长度,每周跑一次就够用。有了这份快照,AI 才能判断某个页面内容是否完整、有没有覆盖搜索意图、是不是 Thin Content、需不需要更新。
这三类数据加上前面几项,都要进入同一套持续更新的流程,不能导完一次就不管。系统每周刷新一次 BigQuery 里的搜索和行为数据,同步一次竞品关键词,更新一次内容快照,再跑分析和生成建议。
每周的自动更新流程
每周任务
定时触发的入口
更新 BigQuery 数据
搜索与行为数据刷新一遍
同步竞品关键词
排名、页面与预估流量变化
更新网站内容快照
页面与文章的最新版本
运行 SEO 分析
按模型筛出机会与问题
生成优化建议
交给人执行的清单
跑上几个月之后,沉淀下来的东西会越来越有用:搜索数据、用户行为数据、商业关键词数据、竞争环境数据和网站内容数据都在同一个仓库里,每次分析都能同时看到企业自己、外部市场和已有内容这三个层面。这也是自建系统相比通用 SEO 工具最实际的差别。通用工具给你的是一份行业数据,谁都能买到;自建系统给出的建议,是从你自己的数据里算出来的。
7. VPS 服务器
为了让系统持续运行,需要部署服务器。服务器主要负责后端服务、数据库、Dashboard 和定时任务,可以选择云服务器、VPS 或 Docker 环境。对于个人开发和小团队,低成本 VPS 已经足够支持这种类型的 AI 应用。推荐使用 Hostinger 或 腾讯云轻量应用服务器。
不要让 Agent 直接写代码,先让它理解项目
这是整个开发过程中最重要的一步。很多 AI 项目失败,不是因为 Agent 不会写代码,而是因为 Agent 根本不知道自己应该解决什么问题。
例如你告诉 Agent“开发一个 SEO Dashboard。”它可能创建几个统计卡片、几张趋势图和一个漂亮首页,但是它不知道哪些指标重要、哪些分析对业务有价值。因此,正确流程应该是先建立项目上下文。
传统开发方式
过去是从需求出发,经过产品经理、设计、开发,最后进入测试:
传统开发方式
需求
→
产品经理
→
设计
→
开发
→
测试
Agent 开发方式
现在是从业务目标出发,先写项目文档,让 Agent 理解,再生成方案并进入开发实现:
Agent 开发方式
业务目标
→
项目文档
→
AI Agent 理解
→
生成方案
→
开发实现
在正式开发之前,需要准备项目文档。例如:
project/
├── README.md
├── BUSINESS.md
├── DATA_SCHEMA.md
├── PLAN.md
├── TODO.md
└── CLAUDE.md
BUSINESS.md:告诉 Agent 为什么做
记录企业类型、SEO 目标、用户需求和系统价值。例如:这是一个面向跨境企业网站的 SEO 数据分析系统,用于自动发现关键词机会和页面优化方向。
DATA_SCHEMA.md:告诉 Agent 数据是什么
记录数据来源、表结构和字段关系。例如 Search Console 的数据包含以下字段:
Search Console
keyword
click
impression
position
CTR
PLAN.md:告诉 Agent 开发顺序
例如:
- 第一阶段:数据连接
- 第二阶段:数据库设计
- 第三阶段:分析模块
- 第四阶段:Dashboard
- 第五阶段:自动报告
CLAUDE.md:定义 Agent 工作规则
告诉 Agent 项目规范、技术要求、编码方式和注意事项。这样 Agent 不再是一次性代码生成工具,而变成长期参与项目的工程助手。
下一章开始,将进入真正的系统设计阶段:如何让 Agent 设计 SEO Copilot 架构,以及如何建立数据仓库。
让 Agent 成为产品经理,先设计系统,再开始开发
完成基础准备之后,下一步并不是马上让 Agent 编写代码。很多 AI 项目失败的原因,并不是技术问题,而是开发之前没有完成产品设计。过去的软件开发流程中,产品经理负责明确业务目标、拆解功能需求、设计用户流程、定义验收标准,而在 AI Agent 开发模式下,这部分工作依然存在,只是执行者发生了变化:你需要先把业务逻辑整理清楚,让 Agent 理解整个项目。
1. 从功能需求转变为系统能力
最初,我并没有告诉 Agent“帮我做一个 SEO Dashboard。”而是先拆解这套系统需要具备哪些能力。整个 SEO Copilot 可以拆分为六个核心模块,每一层负责不同任务。
SEO Copilot 的六个核心模块
数据采集层(Data Collection)
负责获取原始数据,数据来源包括四个平台:
| 数据源 | 提供的数据 |
|---|---|
| Google Search Console | Query、Click、Impression、CTR、Position |
| Google Analytics 4 | 用户行为、页面访问、转化事件 |
| Google Ads | 投放关键词、点击成本、商业价值参考 |
| WordPress 数据库 | 页面信息、内容结构、发布时间、分类标签 |
这一层的目标不是分析,只是确保所有数据能够稳定进入系统。
数据仓库层(Data Warehouse)
这一层负责存储和整理数据。为什么需要单独的数据仓库?因为不同平台的数据结构完全不同:Search Console 关注搜索表现,GA4 关注用户行为,WordPress 关注内容。如果直接让 AI 读取这些数据,它需要每次重新理解数据在哪里、字段是什么意思,效率非常低。因此需要先建立统一数据层。
SEO 分析引擎(SEO Analysis Engine)
这是整个系统的核心,它负责把原始数据转换成 SEO 洞察。例如一条原始数据:
keyword: example keyword
position: 14
impression: 20000
click: 100
分析之后变成:
机会类型:首页提升机会

原因:排名已经进入第二页
曝光持续增长
CTR 偏低

建议:优化 Title
补充内容
增加内部链接
AI 诊断层(AI Diagnosis)
传统 SEO 工具通常停留在“发现问题”,例如“这个页面 CTR 低。”但是企业真正需要的是“为什么低?怎么办?”因此引入 LLM。AI 负责理解上下文,例如结合页面内容、搜索词、排名和用户行为,生成自然语言建议。
Dashboard 展示层
Dashboard 不是为了展示更多数据,而是为了降低决策成本。核心页面应该围绕“今天应该做什么。”来组织,例如首页展示 SEO 健康评分,关键词机会回答哪些词值得优化,页面诊断回答哪些页面需要修改,内容建议回答下一步更新什么。
2. 定义数据流,而不是先定义页面
很多人开发 Dashboard 时,第一步是设计界面,但是 SEO Copilot 不应该这样。正确的顺序是:
先定义数据流,再定义页面
业务问题
→
需要什么数据
→
如何计算
→
如何分析
→
最后展示
例如问题是“哪些关键词有机会进入首页?”,需要的数据是 keyword、position、impression、click 和 CTR,分析逻辑是 position 落在 8-20 之间、impression 持续增长、与商业相关,输出是一份优化列表。最后才决定 Dashboard 怎么展示。
3. 给 Agent 提供项目上下文
在实际开发过程中,我会要求 Agent 先阅读这几份文件:
PROJECT_CONTEXT.md
DATA_SCHEMA.md
FEATURE_LIST.md
TECH_STACK.md
这些文件相当于项目说明书。PROJECT_CONTEXT.md 告诉 Agent 这个项目是什么,DATA_SCHEMA.md 告诉 Agent 数据如何组织,FEATURE_LIST.md 告诉 Agent 系统需要什么功能,TECH_STACK.md 告诉 Agent 使用哪些技术。这样做的好处是每次启动 Agent,它都能快速恢复项目上下文,这也是 AI Agent 开发区别于传统 ChatGPT 对话的重要地方。
建立 SEO 数据仓库,把分散数据变成企业资产
完成系统规划之后,下一步就是建立数据基础。SEO Copilot 的核心思想不是让 AI 去“猜”,而是让 AI 基于企业自身数据、市场数据以及内容资产进行分析,因此第一步是建立数据仓库。
1. 为什么必须使用 BigQuery?
很多企业做 SEO 分析时,第一反应是导出 Excel。短期没有问题,但是长期会遇到三个麻烦。
数据量增长
一个网站运营几年之后,每天都会产生 Search Console 数据、GA4 事件数据和 Ads 数据,Excel 无法长期管理。
数据无法关联
例如你想知道某个关键词带来的访问有没有产生转化,需要把三个环节的数据关联起来,如果全部靠人工会非常困难。
一次转化要串起三份数据
Search Console
关键词
→
GA4
用户行为
→
CRM
询盘
无法自动化
SEO Copilot 需要每天自动运行,例如每天凌晨拉取最新数据、更新数据库、分析变化、生成报告,这要求数据必须结构化。因此 BigQuery 成为整个系统的数据基础。
2. SEO 数据整体架构
整个数据流从网站自身的数据加上后面三类数据资产开始,先汇聚到 BigQuery,经过数据处理层落到 SEO Analysis Database,再交给 AI Agent,最后输出 SEO Report 和 Dashboard。
SEO 数据整体架构
网站自身的数据
Search Console
Google Analytics 4
Google Ads
额外准备的数据资产
广告关键词结构
竞品关键词数据
网站内容快照
Google BigQuery
统一存储原始数据
↓
数据处理层
清洗、统一字段、按来源拆表
↓
SEO Analysis Database
分析结果落库
↓
AI Agent
解释原因,生成建议
↓
SEO Report / Dashboard
给人看的结论
上面这些数据源不会自动出现在 BigQuery 里。Google 那三项各有自己的导出通道:Search Console 的导出方法在这篇 如何把 Google Search Console 数据导出到 BigQuery,GA4 在这篇 如何把 GA4 数据导出到 BigQuery,Google Ads 在这篇 如何把 Google Ads 数据导出到 BigQuery。广告关键词结构、竞品关键词和网站内容快照没有现成的导出通道,要按第二章第 6 节的做法用定时任务自己同步进来。
3. 数据表设计思路
不要把所有数据混在一起,按照来源拆分。例如:
| 数据表 | 字段 | 保存什么 |
|---|---|---|
| gsc_daily | date、query、page、click、impression、ctr、position | 搜索表现 |
| ga4_daily | date、page、session、engagement、conversion | 用户行为 |
| ads_keyword_daily | date、keyword、click、cost、conversion | 商业价值 |
| ads_keyword_structure | keyword、ad_group、business_value | 商业关键词结构 |
| competitor_keywords | date、competitor、keyword、page、position、traffic | 竞争环境 |
| pages | url、title、content、category、publish_date | 网站内容 |
4. 为什么需要统一字段?
不同数据源的字段名称不同,例如 Search Console 用 click,GA4 用 sessions,WordPress 用 post_status。如果直接分析,AI 需要不断转换,所以需要建立统一模型。最终分析层统一成这些字段:
page
date
traffic
ranking
conversion
content_quality
这样 SEO Agent 才可以理解。
数据进入系统之后,如何设计 SEO 分析引擎?
数据仓库只是基础,真正产生价值的是分析逻辑。SEO Copilot 最核心的部分不是 Dashboard,而是 SEO Analysis Engine,它负责把数据转换成行动。
1. 首页机会检测模型
第一个模型寻找的是“距离首页只有一步的网站机会。”判断条件是:
position: 8-20
impression: 持续增长
query: 商业相关
命中的记录会被系统标记为 Opportunity。输出格式例如:
关键词:Example Keyword
当前排名:13
机会:进入首页
建议:优化页面内容
增加内部链接
提升 E-E-A-T 信号
2. 高曝光低点击分析模型
这是最常见的 SEO 问题。例如一条数据:
impression: 50000
click: 200
CTR: 0.4%
说明 Google 已经大量展示这个页面,但是用户没有点击。可能原因是 Title 不吸引、Description 不匹配、搜索意图错误。AI 会进一步分析页面内容,然后生成建议。
3. 页面转化分析模型
SEO 不能只看流量,企业的最终目标通常是询盘、销售线索和订单,因此需要把这条链路关联起来:
页面转化分析链路
SEO Traffic
→
Landing Page
→
User Behavior
→
Conversion
由此发现哪些页面带来真正的商业价值。
4. Keyword Cannibalization 检测模型
关键词内耗的检测逻辑是查询同一个 keyword 对应多个 URL。例如:
keyword: example keyword
URL A: position 8
URL B: position 15
URL C: position 22
系统会判断可能存在页面竞争,然后建议合并页面、调整页面定位或者设置主要目标页。
5. Thin Content 检测模型
SEO Copilot 还需要理解页面质量,例如检测字数、内容结构、关键词覆盖和内链数量。系统会发现有些页面虽然存在,但是无法满足搜索意图,输出内容补充建议。
6. 为什么分析引擎比 AI 更重要?
很多人认为 AI SEO 就是调用 GPT,实际上不是。LLM 最大的优势是理解,但是它不能替代数据逻辑。正确架构应该是:
规则、数据与 AI 的分工
结构化数据
→
SEO 规则分析
→
AI 理解和生成建议
→
人工决策
AI 负责解释,规则负责发现,数据负责证明,这也是企业级 AI 应用和简单 ChatGPT 使用最大的区别。
下一章将继续进入如何开发 AI SEO 诊断 Agent,让系统自动生成优化建议,包括 Agent 如何读取分析结果、Prompt 设计方式、如何让 AI 理解页面上下文、自动生成 SEO Report,以及周报和月报的自动化流程。
让 AI Agent 真正参与 SEO 分析,从数据监控到智能诊断
前面的章节完成了 SEO Copilot 的基础建设:数据来源接入、数据仓库搭建和 SEO 分析规则设计。但是到这里,系统本质上仍然只是一个自动化数据分析平台。它能够告诉你哪些关键词排名变化、哪些页面流量变化、哪些指标出现异常,但是它还无法回答为什么会出现这个问题、下一步应该怎么优化。而这正是 AI Agent 发挥价值的地方。
SEO Copilot 的核心,并不是简单地把 GPT 接入 Dashboard。真正有效的 AI 应用,需要让 AI 建立在结构化数据和业务逻辑之上。
1. 为什么传统 SEO 报告无法满足企业需求?
很多企业都会定期制作 SEO 报告,通常包括自然流量趋势、关键词数量变化、页面访问情况和排名变化。这些数据本身没有问题,问题在于数据并不会自动产生行动。
例如报告显示某个页面过去 30 天曝光增加 80%、点击增加 20%,CTR 却在下降。这意味着什么?可能存在搜索需求增加、页面排名提升、Title 吸引力不足、搜索意图不匹配几种情况,传统 SEO 人员需要自己进一步分析。而 SEO Copilot 希望解决从“发现数据变化”到“理解变化原因”再到“提出优化建议”这一整个过程。
2. SEO Agent 的工作流程
SEO Agent 并不是直接读取所有网站数据,然后自由发挥。更合理的架构是:
SEO Agent 的工作链路
数据仓库
历史数据与统一字段
SEO 分析模型
用规则先算一遍
异常 / 机会识别
筛出值得看的那几条
AI Agent 理解上下文
读页面与业务背景
生成优化建议
原因、优先级、动作
输出报告
进入 Dashboard 与邮件
其中程序负责数据计算、条件判断和指标筛选,AI 负责理解上下文、解释原因和生成建议,这种组合比单纯依赖 LLM 更可靠。
3. AI Agent 需要哪些上下文?
一个 SEO Agent 如果只知道关键词是 example keyword、排名是 12,它无法给出高质量建议,因为 SEO 判断需要上下文。因此在分析一个页面时,需要提供四类信息。
页面信息
包括 URL、Title、Meta Description、页面正文和页面类型。例如这是产品页面、分类页面、博客文章还是技术资源页面,不同页面类型的优化策略完全不同。
搜索表现数据
包括查询词、点击、展现、CTR、平均排名和历史变化趋势,这些数据告诉 AI Google 如何评价这个页面。
用户行为数据
包括 Session、Engagement、页面停留和转化事件,这些数据告诉 AI 用户是否真正认可这个页面。
企业业务背景
这是很多通用 SEO 工具缺少的部分。例如同一个关键词对于新闻网站可能代表流量价值,对于 B2B 企业可能代表潜在采购需求。AI 必须理解业务目标不同,SEO 判断也不同。
4. SEO 诊断模型设计
SEO Copilot 中可以设计多个 AI 分析模型。
模型一:关键词机会分析
目标是发现最值得投入优化的关键词。例如系统发现:
关键词:Example Keyword
当前排名:14
曝光:持续增长
CTR:较低
AI 判断该关键词已经进入第二页,Google 已经认可页面相关性。建议增加内容深度、补充相关主题、优化页面结构、增加内部链接。
模型二:首页机会页面分析
目标是找到距离首页只有一步的页面。例如页面 /example-page/ 的数据:
排名:11-20
曝光:持续增长
系统输出这是潜在增长页面,优先级为 High。
模型三:高曝光低点击分析
这是企业网站最常见的问题。例如:
Impression: 50000
Click: 200
CTR: 0.4%
说明 Google 大量展示该页面,但是用户没有点击。AI 进一步分析可能原因,包括 Title 吸引力不足、Meta Description 不匹配和搜索意图理解错误,然后生成优化建议。如果站点跑在 WordPress 上,这类修改 Title 和 Meta Description 的活,可以安装插件 All In One SEO,并使用官方的 MCP 进行批量修改。
模型四:关键词内部竞争分析
Keyword Cannibalization(关键词内耗)是企业网站常见问题。例如多个页面同时排名 Example Keyword。
系统会分析哪个页面排名最好、哪个页面获得最多点击、哪个页面内容最匹配,然后建议合并页面、调整页面定位或者设置主要目标页面。
模型五:内容质量分析
SEO 不仅需要排名数据,还需要理解页面内容。系统可以结合页面长度、内容结构、主题覆盖和内部链接,识别薄内容页面、内容过时页面和搜索意图覆盖不足的页面。
5. 为什么 SEO Agent 不是简单调用 GPT?
很多人理解 AI SEO 就是调用一个大模型,输入“帮我优化页面。”但企业级 AI 应用不是这样。真正有效的架构是:
企业级 AI 应用的处理顺序
业务数据
→
数据分析逻辑
→
AI 理解
→
人工决策
AI 的优势是理解语言,但是数据规则决定方向。因此 SEO Copilot 并不是让 AI 替代 SEO,而是让 AI 放大 SEO 专家的判断能力。
搭建 SEO Copilot 的自动化运行系统
完成数据层、分析层和 AI 诊断层之后,下一步就是让系统持续运行。因为 SEO 最大的问题不是不会分析,而是无法长期坚持。
1. 为什么需要自动化?
很多企业的 SEO 流程都会走到同一个结局:第一阶段建立关键词表,第二阶段优化页面,第三阶段停止维护。原因是人工监控的成本太高。SEO Copilot 的目标是让 SEO 监控从“周期性人工检查”变成“持续自动运行”。
2. 自动化运行流程
一个完整的流程是:
每天自动跑一遍的流程
定时任务启动
同步最新 SEO 数据
更新数据仓库
运行分析模型
调用 AI 诊断
生成报告
发送通知
例如每天系统自动检查新出现的排名机会、流量异常页面和 CTR 下降页面;每周生成 SEO 分析报告。
3. 系统部署架构
一个适合企业内部使用的架构是:
VPS 服务器
├── Frontend Dashboard
├── Backend API
├── Database
├── SEO Analysis Worker
└── Scheduler
| 组件 | 负责什么 |
|---|---|
| Frontend Dashboard | 展示分析结果,例如 SEO 总览、关键词机会、页面诊断和优化任务 |
| Backend API | 数据接口、用户请求和系统逻辑 |
| Database | 保存历史 SEO 数据、分析结果和 AI 报告 |
| Analysis Worker | 后台计算,例如每天凌晨执行关键词机会检测、页面异常检测和内容分析 |
| Scheduler | 自动触发任务,类似企业中的定时流程 |
4. 为什么 VPS 足够支持这种 AI 应用?
很多人认为 AI 应用必须使用复杂云架构,实际上对于企业内部 SEO 工具来说,需求通常比较简单:用户数量有限、数据规模可控、主要是定时任务。因此一台普通 VPS 已经可以运行 Web 应用、数据库、API 服务和自动任务。未来规模扩大,再迁移到 Cloud Run、AWS ECS 或 Kubernetes。
5. SEO Copilot 的持续迭代方式
系统上线并不是结束,SEO 本身不断变化,因此工具也需要不断进化。未来可以增加这些方向。
竞争对手监控
自动发现新排名关键词和新内容页面。
内容更新建议
结合页面历史表现和搜索趋势,自动生成内容更新计划。
SEO 实验管理
记录什么时候修改页面、修改了什么、最终效果如何,形成 SEO 实验数据库。
SEO Copilot 完整开发 SOP
前面的篇幅主要是帮助你了解整套系统的设计思路,以及提前准备好开发这套系统所需要的必备工具。我们已经把这套思路总结成一份可以直接丢给 AI Agent 进行开发的完整 SOP。你可以将下面的内容直接交给 Agent,作为开发 SEO Copilot 的完整指引。
# SEO-Copilot 单租户版开发与部署标准作业程序 (Agent Development SOP)

> **文档性质**:面向 AI Coding Agent(如 Claude Code / Codex / Antigravity)的系统构建与工程交付标准作业规范。
> **工程目标**:从零搭建并交付一套**单人自用**的 SEO 智能闭环系统(SEO Copilot),管理自己名下固定的几个网站(1~N 个,写死在配置里,不是自助注册的多租户 SaaS)。包含"数据接入 → 7 类诊断引擎 → 关键词选品与防内耗 → 优先级待办生成 → 28 天归因回测 → LLM 周报"完整业务流水线。
> **执行约束**:严禁冗余理论阐述;严格遵循本 SOP 规定的架构边界、数据契约、目录规范与避坑防御准则。
> **溯源说明**:本 SOP 对照一套已在生产环境稳定运行数月的真实单租户系统源码逐文件校对,覆盖全部 10 个 Python 模块、DDL、部署配置。凡标注"生产验证"的内容均为真实代码行为,可直接照抄;凡标注"设计建议"的内容为简化方案,生产系统未必有对应实现。**这套系统刻意做得很"糙"——没有 ORM、没有迁移工具、没有登录系统、没有任务队列——因为它服务的读者是"一个人管少数几个自己的网站",不是要撑起一个多用户产品。不要把它过度工程化。**

---

## 目录
1. [系统架构与前置资源清单](#一系统架构与前置资源清单)
2. [工程目录与配置文件规范](#二工程目录与配置文件规范)
3. [数据库建模与数据表契约 (PostgreSQL)](#三数据库建模与数据表契约-postgresql)
4. [核心功能模块开发指引 (M1 ~ M8)](#四核心功能模块开发指引-m1--m8)
5. [调度规范:进程内定时任务,无独立 Worker](#五调度规范进程内定时任务无独立-worker)
6. [Docker 编排与部署规范](#六docker-编排与部署规范)
7. [隐性依赖与环境准备清单(从零开始必读)](#七隐性依赖与环境准备清单从零开始必读)
8. [Agent 自动化验收与冒烟测试检查表](#八agent-自动化验收与冒烟测试检查表)
9. [交付终态标准 (Definition of Done)](#九交付终态标准-definition-of-done)

---

## 一、系统架构与前置资源清单

### 1.1 技术栈基准(生产验证)
* **运行环境**:Python 3.12(`python:3.12-slim` 基础镜像)
* **Web 框架**:FastAPI + Jinja2 服务端渲染。**应用层没有任何登录/会话系统**——鉴权完全交给反向代理(Traefik)的 HTTP Basic Auth,FastAPI 里所有路由对内网/已过反代认证的请求一律放行。这是刻意的简化:单人自用不需要一套账户体系。
* **数据访问**:**没有 ORM,没有 Alembic**。直接用 `psycopg[binary]==3.2.*`(psycopg3)+ `dict_row` 行工厂,SQL 语句手写在各模块里,参数用 `%(name)s` 占位符。每个模块顶部内嵌一段 `CREATE TABLE IF NOT EXISTS ...` 的 DDL 字符串,模块的入口函数一执行就先跑一遍 DDL,天然幂等,不需要迁移工具管理 schema 版本。
* **两层存储**:
  - **PostgreSQL 16-alpine** 是应用直接查询的"工作库"——诊断引擎、看板、待办、周报全部读写这里。
  - **Google BigQuery 是上游数据仓库,不是本系统自己搭的**:GA4 的「BigQuery 关联」和 Search Console 的「批量数据导出到 BigQuery」都是 **Google 官方原生功能**,在各自后台点几下开启,数据会自动、按日、持续写入你指定的 BigQuery 数据集,全程不需要写一行代码。本系统只负责每周从 BigQuery 里把匹配的表 **复制(不是查询)** 一份到本地 Postgres,之后所有分析都在 Postgres 里跑 SQL,不产生额外 BigQuery 查询费用。
* **调度**:APScheduler **直接跑在 FastAPI 主进程内**(`lifespan` 里启动),不是独立的 worker 容器,也没有持久化任务队列表。手动触发的操作(如"立即跑一次诊断")用 Python 原生 `threading.Thread` 起一个后台线程执行,不落库、没有重试机制、进程重启就丢失执行状态。这在"每周批一次、失败了人工重跑"的场景下完全够用,不要因为"看起来不够可靠"就引入 Celery/Redis 或数据库任务队列——那是在为不存在的规模问题预先设计。
* **站点清单是写死在代码里的**:`db.py` 里一个 Python dict(`SITES = {"site_a": {...}, "site_b": {...}}`),新增一个站点 = 改代码 + 重新部署,不是通过网页表单创建。这是本系统与"自助 SaaS"最根本的区别,务必保持这个简单性。

### 1.2 前置依赖资源清单
Agent 在初始化项目前,必须核验以下凭据已在环境变量中声明:

| 凭证 / 资源名称 | 环境变量标识 | 必填度 | 获取途径与用途说明 |
|---|---|---|---|
| **数据库连接** | `DATABASE_URL` | 必须 | `postgresql://seocopilot:<pwd>@db:5432/seocopilot`(psycopg3 原生 URL 格式,不需要 `+psycopg` 这种 SQLAlchemy 方言前缀) |
| **Postgres 密码** | `POSTGRES_PASSWORD` | 必须 | 供 `db` 容器和 `DATABASE_URL` 共用 |
| **排名检测凭据** | `SERPER_API_KEY` | 必须 | serper.dev API Key,用于 Google 实时 SERP 抓取 |
| **LLM 周报生成** | `DEEPSEEK_API_KEY` | 必须 | DeepSeek 官方 API Key(`deepseek-chat` 模型) |
| **BigQuery 服务账号** | 不是环境变量,是文件 | 必须 | Google Cloud 服务账号 JSON 密钥,挂载到容器内固定路径 `/srv/gcp-service-account.json`,代码里通过 `GOOGLE_APPLICATION_CREDENTIALS` 环境变量指向它(`bigquery.py` 里 `os.environ.setdefault(...)` 已写死默认路径)。获取方式见第七节。 |

> [!NOTE]
> 本系统**没有** `SECRET_KEY`、`FERNET_KEY`、`GOOGLE_CLIENT_ID/SECRET`、`RESEND_API_KEY` 这些字段——没有会话签名(无登录系统)、没有 OAuth token 需要加密存储(不走自助授权,走服务账号)、没有邮件发送(周报只在网页里看,不外发)。如果你在别的资料里看到这些变量名,那是另一套更复杂的多租户 SaaS 版本的东西,不属于这份单租户 SOP。

---

## 二、工程目录与配置文件规范

### 2.1 目录结构(生产验证)
```text
seocopilot/
├── docker-compose.yml
├── .env.example                 # 需自行创建(真实 .env 不进版本库)
├── gcp-service-account.json     # Google Cloud 服务账号密钥,只读挂载进容器(不进版本库)
├── raw-data/                    # 一次性/周期性原始数据导入目录(只读挂载)
│   ├── <site-a-dir>/
│   │   ├── bigquery-data/       # GSC/GA4 从 BigQuery 导出的 CSV(历史冷启动用;日常增量走 bigquery.py 自动拉)
│   │   │   ├── <site>_gsc_url_daily_web_000000000000.csv
│   │   │   ├── <site>_gsc_query_url_daily_web_000000000000.csv
│   │   │   └── <site>_ga4_landing_page_daily_000000000000.csv
│   │   ├── google-ads-data/     # Google Ads 后台手动导出的 CSV(中文界面表头,见 M1)
│   │   ├── 竞争对手关键词/        # Semrush/Ahrefs 导出的 Excel/CSV,文件名需符合特定格式(见 M1)
│   │   └── 网站content/          # WordPress 内容导出 JSON(pages.json / posts.json,见 M1)
│   └── <site-b-dir>/ ...
└── web/
    ├── Dockerfile
    ├── requirements.txt
    └── app/
        ├── main.py               # FastAPI 入口:路由 + APScheduler 生命周期注册
        ├── db.py                 # 连接工厂 + SITES 站点清单(唯一的"配置中心")
        ├── bigquery.py           # 每周从 BigQuery 增量同步 GSC/GA4 到本地 Postgres
        ├── importer.py           # 一次性/周期性从 raw-data/ 导入 Ads/竞对/WP内容
        ├── selection.py          # 关键词选品:Ads词/竞对缺口词/期望词三路 + 站点归属防内耗
        ├── serper.py             # 排名检测(含分页偏移量避坑逻辑)
        ├── diagnose.py           # 7 类诊断规则引擎
        ├── todos.py              # 待办生成 + 28 天归因回测
        ├── report.py             # 多站合并周报(DeepSeek 生成)
        ├── queries.py            # 看板聚合查询(周趋势/KPI/排名追踪/诊断明细)
        ├── templates/            # Jinja2 模板:base / index / site / tracking / diagnosis / todos / reports / empty
        └── static/               # 站点 logo、favicon 等静态资源
```

> [!IMPORTANT]
> 没有 `models.py`,没有 `alembic/`,没有 `auth.py`,没有 `security.py`——这些在别的(多租户)版本里存在,这套单租户系统统统不需要。**不要凭空加回来。**

### 2.2 路由表(生产验证,全部 8 个路由 + 4 个手动触发端点)

| 方法 | 路径 | 作用 |
|---|---|---|
| GET | `/health` | 健康检查,探测 `SELECT 1` |
| GET | `/` | 重定向到第一个站点的总览页 |
| GET | `/site/{site}` | 单站总览看板 (M2),站点表还没建好时渲染 `empty.html` |
| GET | `/site/{site}/tracking` | 关键词排名追踪表 (M3) |
| GET | `/site/{site}/diagnosis` | 最近一次诊断结果 (M4) |
| GET | `/site/{site}/todos` | 待办列表 (M7) |
| POST | `/todo/{todo_id}/update` | 更新待办状态 + 填写 `feedback`,成功后 303 跳回来源页(`Referer` 头) |
| GET | `/reports` | 历史周报列表(Markdown 渲染成 HTML),**不区分站点**,一份报告覆盖所有站点 |
| POST | `/admin/generate-todos` `/admin/generate-report` `/admin/rank-check` `/admin/diagnose` | 手动立即触发对应任务,起一个后台线程执行,303 跳回来源页 |

`{site}` 路径参数必须是 `db.SITES` 字典里的 key,不存在就 404——这就是站点归属校验的全部逻辑,不需要额外的鉴权依赖。

---

## 三、数据库建模与数据表契约 (PostgreSQL)

**没有集中的 schema 文件**——每张表的 DDL 分散内嵌在"谁用它谁负责建"的模块里,`CREATE TABLE IF NOT EXISTS` + 模块入口函数执行时自动跑一遍。Agent 复刻时把下面每段 DDL 原样放进对应模块文件顶部即可,不要另建一个 `models.py` 集中管理。

### 3.1 数据接入层(`importer.py` 负责建表 + 首次导入;`bigquery.py` 之后负责增量刷新其中 3 张)
```sql
-- gsc_url_daily:GSC 明细,按日 × 落地页
CREATE TABLE IF NOT EXISTS gsc_url_daily (
  site text NOT NULL, data_date date NOT NULL, landing_page text NOT NULL,
  country text, device text,
  impressions int, clicks int, ctr double precision, avg_position double precision);
CREATE INDEX IF NOT EXISTS idx_gud_site_date ON gsc_url_daily (site, data_date);

-- gsc_query_url_daily:GSC 明细,按日 × Query × 落地页
CREATE TABLE IF NOT EXISTS gsc_query_url_daily (
  site text NOT NULL, data_date date NOT NULL, query text NOT NULL, landing_page text NOT NULL,
  country text, device text,
  impressions int, clicks int, ctr double precision, avg_position double precision);
CREATE INDEX IF NOT EXISTS idx_gqud_site_date ON gsc_query_url_daily (site, data_date);
CREATE INDEX IF NOT EXISTS idx_gqud_site_query ON gsc_query_url_daily (site, query);

-- ga4_landing_page_daily:GA4 明细,按日 × 落地页
CREATE TABLE IF NOT EXISTS ga4_landing_page_daily (
  site text NOT NULL, data_date date NOT NULL, landing_page text NOT NULL,
  country text, device text,
  sessions int, engaged_sessions int, engagement_rate double precision,
  engagement_time_seconds double precision, key_events double precision,
  conversion_rate double precision);
CREATE INDEX IF NOT EXISTS idx_ga4_site_date ON ga4_landing_page_daily (site, data_date);

-- ads_keywords:Google Ads 投放关键词表现(手动周期性导入,无 API 自动化)
CREATE TABLE IF NOT EXISTS ads_keywords (
  site text NOT NULL, keyword text NOT NULL, keyword_clean text,
  match_type text, campaign text, ad_group text, kw_status text, status text,
  final_url text, clicks int, impressions int, ctr double precision,
  conversions double precision, cost double precision);

-- competitor_keywords:竞对关键词导出(Semrush/Ahrefs)
CREATE TABLE IF NOT EXISTS competitor_keywords (
  site text NOT NULL, competitor text NOT NULL, geo text,
  keyword text NOT NULL, position int, prev_position int,
  search_volume int, kd double precision, cpc double precision,
  url text, traffic double precision, intents text, position_type text, export_date date);
CREATE INDEX IF NOT EXISTS idx_ck_site_kw ON competitor_keywords (site, keyword);

-- wp_content:WordPress 内容导出快照(title/meta/正文字数——本系统没有网页爬虫,内容信号全部来自这里)
CREATE TABLE IF NOT EXISTS wp_content (
  site text NOT NULL, wp_id bigint, object_type text, slug text, url text,
  title text, seo_title text, meta_description text,
  content_text text, word_count int, published text, modified text);
CREATE INDEX IF NOT EXISTS idx_wp_site_type ON wp_content (site, object_type);
```

### 3.2 分析与执行层(各自模块内嵌 DDL)
```sql
-- tracked_keywords:选品结果(selection.py 建表)
CREATE TABLE IF NOT EXISTS tracked_keywords (
  id serial PRIMARY KEY,
  site text NOT NULL, keyword text NOT NULL, source text NOT NULL,  -- ads | gap | wishlist
  score double precision, reason text,
  search_volume int, kd double precision,
  active boolean DEFAULT true,
  created_at timestamptz DEFAULT now(),
  UNIQUE (site, keyword, source));

-- rank_check_runs / rank_checks:排名检测批次与结果(selection.py 建表,serper.py 写入)
CREATE TABLE IF NOT EXISTS rank_check_runs (
  id serial PRIMARY KEY,
  started_at timestamptz DEFAULT now(), finished_at timestamptz,
  trigger text, keywords int DEFAULT 0, errors int DEFAULT 0);

CREATE TABLE IF NOT EXISTS rank_checks (
  id serial PRIMARY KEY,
  run_id int REFERENCES rank_check_runs (id),
  site text NOT NULL, keyword text NOT NULL,
  check_date date DEFAULT current_date,
  position int, url text);              -- position NULL = 未进前 30
CREATE INDEX IF NOT EXISTS idx_rc_site_kw ON rank_checks (site, keyword, check_date);

-- diagnostics:诊断结果(diagnose.py 建表,同站同日重跑先删后插)
CREATE TABLE IF NOT EXISTS diagnostics (
  id serial PRIMARY KEY,
  site text NOT NULL, run_date date DEFAULT current_date,
  rule text NOT NULL, severity text NOT NULL,
  subject text NOT NULL, url text, details jsonb, score double precision);
CREATE INDEX IF NOT EXISTS idx_diag_site_date ON diagnostics (site, run_date);

-- todos:闭环待办(todos.py 建表)
CREATE TABLE IF NOT EXISTS todos (
  id serial PRIMARY KEY,
  site text NOT NULL,
  rule text NOT NULL, severity text,
  title text NOT NULL, description text,
  subject text, url text,
  status text NOT NULL DEFAULT 'open',   -- open | in_progress | done | dismissed
  feedback text,
  baseline jsonb,                         -- 创建时的 28 天窗口快照
  created_at timestamptz DEFAULT now(),
  completed_at timestamptz,
  UNIQUE (site, rule, subject));

-- weekly_reports:周报持久化(report.py 建表)——注意没有 site_id,一份报告覆盖全部站点
CREATE TABLE IF NOT EXISTS weekly_reports (
  id serial PRIMARY KEY,
  week_start date NOT NULL,
  content_md text NOT NULL,
  model text, created_at timestamptz DEFAULT now());
```

> [!CAUTION]
> **归因回测同样是按需计算,不落库。** `todos.py` 的 `impact()` 函数在每次渲染待办列表时用 `completed_at` 现算前后 28 天对比,`todos` 表里没有专门的归因结果字段。

---

## 四、核心功能模块开发指引 (M1 ~ M8)

### M1 · 数据接入:两条独立的线(生产验证)

**线 A:BigQuery 自动增量同步(日常持续运行,无需人工干预)**

前提:GA4 已在后台开启「BigQuery 关联」,Search Console 已开启「批量数据导出」——这两项都是 Google 原生功能,在对应产品的管理后台点开启即可,不需要写代码(详见第七节)。开启后 Google 会自动、按日、持续把数据写进指定的 BigQuery 数据集,本系统完全不参与这个环节。

`bigquery.py` 做的事:
- `discover(client)`:遍历 GCP 项目下所有 BigQuery 数据集和表,按"数据集名或表名包含站点 key" + "表名命中 `TABLE_PATTERNS` 关键字"做模糊匹配(GA4 视图名里通常带日期分区/站点名,命名不完全规整,所以用关键字匹配而不是精确表名):
  ```python
  TABLE_PATTERNS = {
      "gsc_url_daily": ["gsc_url_daily_web"],
      "gsc_query_url_daily": ["gsc_query_url_daily_web"],
      "ga4_landing_page_daily": ["ga4", "landing_page_daily"],
  }
  ```
- `pull(trigger)`:对每个匹配到的 (站点, 本地表) 组合,`SELECT` 出 BigQuery 里的全部列,本地先 `DELETE FROM <table> WHERE site = ?` 再用 `cur.copy(...)` 批量写入(`COPY ... FROM STDIN`,比逐行 `INSERT` 快得多)。**幂等**:每次都是"删了重灌",不是增量 upsert,所以可以放心重跑。
- 只拉 **GSC + GA4** 三张表,Google Ads、竞对数据、WordPress 内容不走这条线(BigQuery 里没有这些,见线 B)。
- `python -m app.bigquery test` 可以单独跑连接测试,列出项目里所有数据集/表及行数,方便排查"为什么没匹配到"。

**线 B:一次性/周期性原始文件导入(人工往 `raw-data/` 里丢文件,跑一次导入脚本)**

`importer.py` 处理四类数据,各自的目录/文件名约定必须严格遵守(否则解析器识别不到):

1. **GSC/GA4 历史 CSV**(`raw-data/<site>/bigquery-data/*.csv`)——首次冷启动时,从 BigQuery 手动导出历史数据(多个月/年)批量灌入本地库;此后交给线 A 自动增量,这里就不用再动了。文件名里带 `gsc_url_daily` / `gsc_query_url_daily` / `ga4_landing_page_daily` 关键字即可被通配符 `glob` 匹配到。
2. **Google Ads 导出**(`raw-data/<site>/google-ads-data/*.csv`)——Google Ads 后台手动导出,注意**中文界面导出的 CSV 前两行是标题/汇总行,代码里 `lines[2:]` 跳过**,表头字段用中文名映射:
   ```python
   ADS_COLMAP = {"关键字": "keyword", "匹配类型": "match_type", "广告系列": "campaign",
                 "广告组": "ad_group", "关键字状态": "kw_status", "状态": "status",
                 "最终到达网址": "final_url", "点击次数": "clicks", "展示次数": "impressions",
                 "点击率": "ctr", "转化次数": "conversions", "费用": "cost"}
   ```
   如果你的 Google Ads 账号界面语言是英文,字段名要相应改成英文表头。**没有 API 自动化,纯手动周期性导出+导入**。
3. **竞对关键词导出**(`raw-data/<site>/竞争对手关键词/*.xlsx|*.csv`,Semrush 格式)——文件名必须匹配正则 `(.+?)-organic\.Positions-(\w{2})-(\d{8})-`(Semrush 默认导出文件名就是这个格式:`<竞对域名>-organic.Positions-<地区>-<日期>-...`),从文件名里反解出竞对域名/地区/导出日期,不需要额外填表单。
4. **WordPress 内容导出**(`raw-data/<site>/网站content/*.json`)——JSON 结构预期为 `{"items": [...], "collection"/"post_type": "..."}`,每个 item 需要有 `title`/`content`(或 `content_text`)/`url`(或 `link`)/`slug` 等字段;HTML 标签会被正则剥离、按空格分词统计 `word_count`。**这份 JSON 从哪来不属于本系统范围**——你需要自己写一个小脚本或用现成 WP 插件把内容导出成这个结构,本 SOP 不含该脚本。

`importer.py` 的入口 `main(root)` 对四类数据挨个跑一遍,每张表先 `TRUNCATE` 再全量重载(不是增量),所以整个导入过程是幂等的,可以放心重复执行。

### M2 · 站点监控看板 (`queries.py`,生产验证)
- `weekly_series(site)`:按 `date_trunc('week', data_date)` 聚合 query 维度和 page 维度两套 Top10/Page2-3 词数,加曝光/点击/CTR/GA4 sessions/key_events。
- `kpis(site)`:近 28 天 vs 前 28 天环比。
- `query_table(site, bucket)`:`bucket='p1'` → position≤10,否则 10<position≤30 的明细表。
- `table_counts(site)`:六张接入表各自的行数,用于在页面上快速判断"这个站点哪类数据还没导入"。
- `tracking_data(site)`:追踪关键词 + 最新/上一次排名 + 最近 12 次历史(`LATERAL` 子查询取每个关键词最近的 `rank_checks` 记录)。
- `diagnosis_data(site)`:最近一次诊断的全部发现,按规则/严重度排序。

### M3 · 关键词排名追踪 (Serper API,生产验证,可直接照抄)
> [!CAUTION]
> **Serper 分页陷阱(硬性约束)**:请求 `page=2/3` 时 `organic[i].position` 从 1 重新计数;单页结果可能不足 10 条。必须用**累计偏移量**(历史各页真实返回条数之和)+ 页内下标算全局排名,累加值用 `len(organic)` 而不是固定 `+10`。

**本系统的额外优化**:如果同一个关键词被多个站点同时追踪,**只发一次 SERP 请求,结果里各自找各自的域名**,不重复调用 API:
```python
def _run(trigger):
    key = os.environ["SERPER_API_KEY"]
    domains = {site: cfg["domain"].replace("https://", "").replace("http://", "")
               for site, cfg in SITES.items()}
    rows = ...  # SELECT DISTINCT site, keyword FROM tracked_keywords WHERE active
    by_kw = {}
    for r in rows:
        by_kw.setdefault(r["keyword"], []).append(r["site"])

    for kw, sites in by_kw.items():
        found = {}   # site -> (position, url)
        offset = 0
        for page in (1, 2, 3):
            resp = requests.post(SERPER_URL, json={"q": kw, "gl": "us", "hl": "en", "page": page},
                                 headers={"X-API-KEY": key, "Content-Type": "application/json"},
                                 timeout=30)
            organic = resp.json().get("organic", [])
            for i, item in enumerate(organic):
                link = item.get("link", "")
                for site in sites:
                    if site not in found and domains[site] in link:
                        found[site] = (offset + i + 1, link)
            offset += len(organic)
            if len(found) == len(sites) or len(organic) == 0 or offset >= 30:
                break   # 该词命中的站点已全部找到位置,或翻到头了,提前结束
            time.sleep(0.2)
        # 未命中的站点 position/url 写 None(未进前 30)
```
- 用 `threading.Lock()`(`_lock.acquire(blocking=False)`)防止定时任务和手动触发同时跑——**不是数据库锁,是进程内锁**,单容器场景下够用;如果以后要横向扩容多个 web 副本,这个锁就失效了(当前系统就是单容器部署,不存在这个问题)。
- 每次批量检测先插一条 `rank_check_runs`,逐关键词写 `rank_checks`。

### M4 · 七类核心 SEO 诊断规则引擎(生产验证,阈值来自真实生产数据,不要改数字)
在 `diagnose.py` 实现,均以最近 **28 天**窗口 SQL 聚合为输入:

1. **`low_ctr` 高曝光低 CTR**:`impressions≥40` 且加权平均 `position≤10` 且 `CTR<1%`。`imp≥100` 记 `high`,否则 `medium`。
2. **`page2` 第二页机会**:`impressions≥30` 且加权平均 `position BETWEEN 8 AND 20`。
3. **`cannibalization` 关键词内耗**:同一 query 28 天内命中 `≥2` 个不同落地页且合计 `impressions≥30`;命中页数 `≥4` 记 `high`。
4. **`thin_page` 薄内容**(依赖 `wp_content`):`word_count<150` 且 `impressions≥20`,`object_type` 限 `page`/`post`。
5. **`click_no_session` 有点击无会话**(依赖 GA4):`clicks≥3` 但 `sessions==0`。
6. **`no_conversion` 高访问无转化**(依赖 GA4):`sessions≥30` 但 `sum(key_events)==0`。
7. **`meta` Meta 标签体检**(依赖 `wp_content`):`seo_title`(不是 `title`!本系统里页面的 SEO 标题单独存一列)长度 `>60` 记标题过长;**标题不含品牌名**(大小写、空格归一化后比对)也算一条问题,附带具体品牌名传进来:
   ```python
   BRAND = {"site_a": "Brand A", "site_b": "Brand B"}
   if brand.lower().replace(" ", "") not in seo_title.lower().replace(" ", ""):
       emit("标题缺品牌", "low", subj, url, {"cur": seo_title}, 1, f"标题追加 '| {brand}'")
   ```
   `meta_description` 长度 `<70` 记太短,`>200` 记疑似正文截断,缺失记缺描述;同一 `seo_title` 出现在 `>1` 个页面记标题重复。

> [!IMPORTANT]
> **本系统没有"GA4/爬虫数据缺失时优雅跳过"的探测逻辑**——因为站点清单是固定的三五个,接入数据是一次性导入齐全的,不存在"半路加个新站点还没导数据"的中间态。如果你的场景里站点会陆续增加、数据接入有先后顺序,自己在 `run()` 里加一个"该站点是否已有 GA4/wp_content 数据"的判断,跳过对应规则,不要空跑报错。
>
> **噪声抑制(仅 `meta` 规则)**:有曝光(`impressions≥20`)的问题逐条输出,无曝光/低曝光页面同一问题类型聚合成一条 `"[批量] 标题过长 ×N"`,附最多 6 个示例 URL。
>
> **幂等重跑**:每次先 `DELETE FROM diagnostics WHERE site=? AND run_date=current_date` 再插入。

### M5 · 关键词选品与站点防内耗(生产验证,这是本系统真正的核心亮点,务必完整实现)
`selection.py` 从**三路来源**筛出候选词,写入 `tracked_keywords`:

1. **`ads` Google Ads 已验证词**:有转化、或有点击、或曝光 `≥30` 的投放词才算"有价值",打分 `conversions*100 + clicks*3 + impressions*0.02`。
2. **`gap` 竞对缺口词**:竞对进入过前 15 名、且(我方未追踪 或 加权平均排名 `>20`)的词。机会分:
   $$\text{score} = \frac{\text{search\_volume}}{\text{KD}+5} \times (\text{commercial/transactional 意图 ? } 1.5 : 1) \times \min(1+0.1\times(\text{命中竞对数}-1),\ 1.5)$$
3. **`wishlist` 期望词**:一份手工维护的种子词表(`raw-data/wishlist-keywords.csv`,一列 `term`),join 竞对数据拿 volume/KD 打分;已进前 10 的不再追踪;词里带数字(型号/规格)视为购买意图强,分数 `×1.3`。

**跨站防内耗(原创亮点,务必实现)**:每个候选词先跑一遍归属规则,**从上到下第一个正则命中就归给对应站点**,同一个词绝不会被两个自营站点同时追踪:
```python
SITE_RULES = [
    ("site_a", r"关键词模式1|关键词模式2|..."),   # 例如某类目专属术语
    ("site_b", r"关键词模式3|关键词模式4|..."),
    ("site_c", r"关键词模式5|..."),
]

def assign_site(kw):
    for site, pat in SITE_RULES:
        if re.search(pat, kw):
            return site
    return None   # 三个站都不命中的词直接丢弃,不追踪
```
每个来源每站上限 100 个词(按 score 降序截断)。写库用 `ON CONFLICT (site, keyword, source) DO UPDATE`(存在则刷新分数/原因,不存在则插入),本轮未再入选的词先整体 `active=false`(保留历史排名数据,不删除)。

### M6 · AI 搜索可见度 (GEO) 监控管道(设计建议,生产系统未实现)
同多租户版本 SOP 的描述:非品牌通用商业提问矩阵 + 调用带联网搜索的 LLM API + 正则比对 citations 是否命中自家域名。如果要做,建议独立一张 `geo_checks` 表(`site`, `query`, `platform`, `cited`, `citation_rank`, `checked_at`),单独一个模块,不要和现有诊断规则混在一起。

### M7 · 行动闭环与 28 天归因回测(生产验证)
1. **待办生成 (`todos.generate`)**:每站每规则从当天最新诊断里按 `severity` 再按 `score` 取 Top N(`RULE_CAPS`:`low_ctr=10, cannibalization=6, page2=10, thin_page=5, click_no_session=1, no_conversion=5, meta=8`)。`(site, rule, subject)` 已存在则 `ON CONFLICT DO NOTHING`,不重复插入、不覆盖已有状态。
2. **创建时基线快照**:优先按 query 维度查 28 天窗口(`subject` 是关键词场景),查不到退化到按落地页维度查。
3. **状态流转**:`open → in_progress → done → dismissed`,前端表单提交 `status` + `feedback`(做了什么改动),`feedback` 为空时保留原值不覆盖(`coalesce(nullif(%s,''), feedback)`)。
4. **归因回测 `impact()`**:按需现算,不落库。用 `completed_at` 切一刀,对比"完成前 28 天"与"完成后至今"两段窗口的 impressions/clicks/加权 position,返回 `days_after`。UI 层 `days_after<7` 应提示"数据积累中"。

### M8 · LLM 多站合并周报(生产验证,注意这里和"每站一份"的设计不同)
1. **上下文组装 (`report._collect`)**:**遍历全部站点**,为每个站点收集最近 8 周趋势、28 天 KPI 环比、最新两次排名检测对比(涨跌 Top 10)、最新诊断规则×严重度计数、待办状态计数+最近 5 条已完成反馈,汇总成 `{site_a: {...}, site_b: {...}, ...}` 一个大 JSON。
2. **一次 LLM 调用生成一份覆盖所有站点的周报**(不是每站单独调一次):
   ```text
   系统 Prompt(中文站点用中文写):
   你是一名资深 B2B 工业品独立站 SEO 顾问。基于给定的多个站点的数据 JSON,
   写一份本周 SEO 周报(markdown,无需一级标题)。结构:
   ## 总体概述 —— 所有站点本周核心变化,3-5 句,指出最重要的信号
   ## 各站 SWOT —— 每站一个三级标题,S/W/O/T 各 1-3 条,必须引用具体数据
   ## 本周行动优先级 —— 全局 Top 5,按预期影响排序,每条注明站点/动作/预期效果
   要求:只依据给定数据,不编造;数字保留原值;语言精炼直接,避免空话。
   ```
   DeepSeek `deepseek-chat`,`temperature=0.4, max_tokens=3000`。
3. **持久化,无邮件发送**:`content_md` 存 `weekly_reports.content_md`,`week_start` 记当天日期。**这个系统不发邮件**——周报只在 `/reports` 页面用 `markdown` 库渲染成 HTML 查看。如果你想要邮件推送,自己接一个 Resend/SMTP,属于本 SOP 范围外的增强。

---

## 五、调度规范:进程内定时任务,无独立 Worker

### 5.1 定时流水线(生产验证,`main.py` 的 `lifespan` 里注册)
```python
@asynccontextmanager
async def lifespan(app):
    sched = BackgroundScheduler(timezone="UTC")
    # 周一流水线(UTC):02:00 拉 BigQuery → 03:00 查排名 → 05:00 诊断 → 05:30 生成 to-do → 06:00 LLM 周报
    sched.add_job(lambda: bigquery.pull("weekly"),  CronTrigger(day_of_week="mon", hour=2), id="weekly_bq_pull")
    sched.add_job(lambda: serper.run_check("weekly"), CronTrigger(day_of_week="mon", hour=3), id="weekly_rank_check")
    sched.add_job(lambda: diagnose.run("weekly"),   CronTrigger(day_of_week="mon", hour=5), id="weekly_diagnose")
    sched.add_job(lambda: todos.generate("weekly"), CronTrigger(day_of_week="mon", hour=5, minute=30), id="weekly_todos")
    sched.add_job(lambda: report.generate("weekly"), CronTrigger(day_of_week="mon", hour=6), id="weekly_report")
    sched.start()
    yield
    sched.shutdown(wait=False)
```
**全部串行、全部周一跑**,没有每日增量刷新——因为 BigQuery 那边 Google 已经每天在自动更新底层数据,本系统每周批一次拉过来就够用(周报也是周维度产出,没必要日更)。如果你的使用场景需要更高频率的数据新鲜度,把 `bigquery.pull` 单独拆一条每日 cron 出来即可,其余诊断/选品/周报维持周频没问题。

### 5.2 手动触发:后台线程,不是任务队列
```python
@app.post("/admin/diagnose")
def trigger_diagnose(request: Request):
    threading.Thread(target=diagnose.run, args=("manual",), daemon=True).start()
    return RedirectResponse(request.headers.get("referer") or "/", status_code=303)
```
点击按钮 → 起一个 daemon 线程跑完就完事 → 页面立刻 303 跳转(**不等任务跑完**,用户需要手动刷新页面看结果)。**没有执行状态追踪、没有失败重试、进程重启会直接丢失正在跑的线程**。这是刻意的权衡:一个人管几个网站,一周批一次,手动点一下立即触发,出了问题看容器日志、重新点一下按钮就行——为这个规模引入持久化任务队列纯属过度设计。

### 5.3 幂等性保障
- `gsc_url_daily`/`gsc_query_url_daily`/`ga4_landing_page_daily`:`bigquery.pull()` 每次先 `DELETE WHERE site=?` 再 `COPY` 写入。
- `diagnostics`:先 `DELETE WHERE site=? AND run_date=current_date` 再插入。
- `todos`:靠 `UNIQUE (site, rule, subject)` + `ON CONFLICT DO NOTHING` 天然防重复。
- `tracked_keywords`:`ON CONFLICT (site, keyword, source) DO UPDATE`,本轮未再入选的整体 `active=false`。
- `importer.py` 四类原始数据:每次先 `TRUNCATE` 对应表再全量重载。

---

## 六、Docker 编排与部署规范

### 6.1 `docker-compose.yml`(生产验证)
```yaml
services:
  web:
    build: ./web
    container_name: seocopilot-web
    restart: unless-stopped
    env_file: .env
    volumes:
      - ./raw-data:/srv/raw-data:ro
      - ./gcp-service-account.json:/srv/gcp-service-account.json:ro
    depends_on:
      db:
        condition: service_healthy
    labels:
      - "traefik.enable=true"
      - "traefik.http.routers.seocopilot.entrypoints=websecure"
      - "traefik.http.routers.seocopilot.rule=Host(`seocopilot.yourdomain.com`)"
      - "traefik.http.routers.seocopilot.tls.certresolver=letsencrypt"
      - "traefik.http.routers.seocopilot.middlewares=seocopilot-auth"
      - "traefik.http.services.seocopilot.loadbalancer.server.port=8000"
      # htpasswd 生成的 Basic Auth 凭证,$ 要转义成 $$(compose 变量插值规则):
      - "traefik.http.middlewares.seocopilot-auth.basicauth.users=<user>:<htpasswd-hash>"

  # 一次性任务专用容器:不挂 Traefik 标签,避免被反代误纳入负载均衡
  # 用法:docker compose run --rm jobs python -m app.importer
  #       docker compose run --rm jobs python -m app.selection
  jobs:
    build: ./web
    profiles: ["tools"]
    env_file: .env
    volumes:
      - ./raw-data:/srv/raw-data:ro
      - ./gcp-service-account.json:/srv/gcp-service-account.json:ro
    depends_on:
      db:
        condition: service_healthy

  db:
    image: postgres:16-alpine
    container_name: seocopilot-db
    restart: unless-stopped
    environment:
      POSTGRES_DB: seocopilot
      POSTGRES_USER: seocopilot
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - pgdata:/var/lib/postgresql/data
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U seocopilot -d seocopilot"]
      interval: 5s
      timeout: 3s
      retries: 10

volumes:
  pgdata:
```
**没有独立 worker 容器**——第五节讲过,调度和手动触发都在 `web` 进程里完成,不需要第二个跑业务逻辑的容器。`jobs` 这个 profile 容器只是为了不常跑的一次性命令(导入原始文件、重新选品)单独开一个 shell,平时不启动(`profiles: ["tools"]` 意味着 `docker compose up` 默认不会拉起它)。

**Basic Auth 生成方式**:`htpasswd -nb <用户名> <密码>` 生成一行 `user:$apr1$...` 格式的哈希,填进上面的 label,注意 compose 文件里 `$` 要写成 `$$` 转义。不想装 htpasswd 也可以用在线工具或 `openssl passwd -apr1`。

### 6.2 `Dockerfile`
```dockerfile
FROM python:3.12-slim
WORKDIR /srv
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY app ./app
EXPOSE 8000
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "8000"]
```
比多租户版本简单得多:没有 `alembic upgrade head` 前置步骤(没有迁移工具),没有健康检查探针(Traefik 层面探测就够)。

### 6.3 `requirements.txt`(生产验证)
```text
fastapi==0.116.*
uvicorn[standard]==0.35.*
jinja2==3.1.*
psycopg[binary]==3.2.*
pandas==2.2.*
openpyxl==3.1.*
requests==2.32.*
apscheduler==3.10.*
markdown==3.7
python-multipart==0.0.*
google-cloud-bigquery==3.*
```
**没有**:SQLAlchemy、Alembic、argon2-cffi、cryptography、google-auth/google-auth-oauthlib(没有 OAuth 自助连接流程)、beautifulsoup4(没有网页爬虫)。`pandas`/`openpyxl` 是为了 `importer.py` 读竞对 Excel 导出文件;`google-cloud-bigquery` 是官方 BigQuery Python 客户端,只在 `bigquery.py` 里用到。

---

## 七、隐性依赖与环境准备清单(从零开始必读)

这套系统最容易卡住陌生人的地方,不是写代码,是 **Google 那边几个后台开关**,本 SOP 之前的版本完全没提到过,务必照做:

1. **GA4 → BigQuery 关联(Google 原生功能,免费额度内足够个人用量)**:GA4 后台 → 管理 → 产品链接 → BigQuery 链接 → 新建链接,选一个 GCP 项目,勾选每日导出(免费版有次数限制,够用)。开启后通常次日开始在指定数据集里出现每日分区表。
2. **Search Console → 批量数据导出(同样是 Google 原生功能)**:Search Console 设置 → 批量数据导出 → 选同一个(或另一个)GCP 项目和数据集。**前提是你对该 GCP 项目有 Owner/Editor 权限**,且该 Search Console 资源已验证所有权。开启后同样是次日开始按天写入。
3. **GCP 服务账号**:在启用了 BigQuery API 的 GCP 项目里创建一个服务账号,赋予 **BigQuery Data Viewer**(读表)+ **BigQuery Job User**(跑查询)角色即可,不需要更高权限;下载 JSON 密钥文件,挂载进容器路径 `/srv/gcp-service-account.json`(对应 compose 里的 volume 映射),**这个文件不能进版本库**。
4. **首次冷启动数据从哪来**:BigQuery 关联开启后只会有"从开启那天起"的数据,没有历史。如果需要更早的历史数据,去 BigQuery 控制台手动跑 SQL 导出历史范围的 CSV,放进 `raw-data/<site>/bigquery-data/`,跑一次 `importer.py` 做冷启动灌入;之后交给 `bigquery.pull()` 自动增量。
5. **Google Ads 数据是纯手动的**:没有 API 自动拉取,需要定期去 Google Ads 后台手动导出关键词报表 CSV,放进 `raw-data/<site>/google-ads-data/`,跑一次 `importer.py`(这一步没有自动化,是本系统唯一"需要人隔三差五手动操作"的环节,如果你想自动化,接 Google Ads API 是合理的后续改进方向,不在本 SOP 范围内)。
6. **竞对数据**:Semrush/Ahrefs 之类工具手动导出 Organic Positions 报告(Excel/CSV),文件名保持工具默认导出格式(形如 `域名-organic.Positions-地区-日期-...`),扔进 `raw-data/<site>/竞争对手关键词/`。
7. **WordPress 内容导出**:需要一份结构化 JSON(`{"items": [...]}`),本 SOP 不含生成这份 JSON 的具体脚本/插件——如果你用 WordPress REST API,写一个几十行的脚本批量拉 `posts`/`pages`/`products` 并按上文 3.1 节 `wp_content` 表要求的字段整理输出即可。
8. **Traefik + Basic Auth**:如果你已经有 Traefik 在跑,加一个 router + middleware 标签就行;如果没有反代,本地部署直接用 `docker compose up`,`web` 容器加一行 `ports: ["8000:8000"]` 本机访问即可,个人使用没必要强求 HTTPS。
9. **Serper.dev / DeepSeek 账号**:注册拿 API Key,跟前面版本 SOP 一致。

---

## 八、Agent 自动化验收与冒烟测试检查表

> 生产项目没有 `tests/` 目录,没有 pytest。以下是手工冒烟验证序列:

```bash
# 1. 健康检查 + 数据库连通性
curl -s http://localhost:8000/health

# 2. BigQuery 连接测试(列出项目下所有数据集/表,确认能匹配到你的站点)
docker compose run --rm jobs python -m app.bigquery test

# 3. 首次冷启动导入(需要 raw-data/ 已按第七节目录约定准备好文件)
docker compose run --rm jobs python -m app.importer /srv/raw-data

# 4. 关键词选品(依赖第 3 步的 ads_keywords / competitor_keywords 已导入)
docker compose run --rm jobs python -m app.selection /srv/raw-data

# 5. 排名检测(依赖第 4 步已生成 tracked_keywords)
docker compose run --rm jobs python -c "from app.serper import run_check; print(run_check('manual'))"

# 6. 诊断引擎(依赖第 3 步 GSC 数据 + wp_content 已导入)
docker compose run --rm jobs python -c "from app.diagnose import run; run('manual')"

# 7. 待办生成
docker compose run --rm jobs python -c "from app.todos import generate; print(generate('manual'))"

# 8. 周报生成(依赖前面全部步骤都有数据)
docker compose run --rm jobs python -c "from app.report import generate; print(len(generate('manual')))"

# 9. 页面走查:浏览器打开 http://localhost:8000/site/<你的站点key> 确认看板/排名/诊断/待办四个页面都有数据
```
按 3→4→5→6→7→8 的顺序跑一遍,任何一步空跑(0 条结果)说明上一步的数据没导对,回头检查 `raw-data/` 目录结构和文件名是否符合第七节的约定。

---

## 九、交付终态标准 (Definition of Done)

1. **BigQuery 自动同步跑通**:GA4/GSC 的 BigQuery 关联已在 Google 后台开启,`bigquery.py test` 能列出并匹配到全部站点的三张表。
2. **原始数据冷启动完成**:`importer.py` 跑完后 `table_counts()` 六张表都有非零行数。
3. **选品与防内耗生效**:`tracked_keywords` 里每个关键词只归属一个站点(`SITE_RULES` 正则命中且互斥)。
4. **Serper 翻页避坑已落地**:累计偏移量算法,且同词多站去重成一次请求。
5. **7 类诊断规则全部跑通**,`meta` 规则含品牌后缀检查。
6. **待办闭环生效**:诊断 → 待办生成 → 用户标记完成 → `impact()` 能算出前后 28 天对比。
7. **周报可生成**:多站合并成一份 Markdown,存库可在 `/reports` 查看(不要求邮件发送)。
8. **调度确认**:APScheduler 在 `web` 进程内按周一流水线顺序触发,手动触发端点能正常起后台线程执行且不阻塞请求。
9. **部署隔离**:`web` 挂 Traefik + Basic Auth 标签,`jobs` 容器不挂任何反代标签,仅用于一次性命令。

---

## 附:免责声明

本 SOP 基于一套真实运行的单租户生产系统源码逐文件校对整理,技术选型(无 ORM、无迁移工具、无登录系统、无持久化任务队列)都是服务于"一个人管理少数几个自己的网站"这个明确场景的刻意简化,不是能力不足。如果你的场景膨胀到"需要自助多用户注册、按需接入任意数量站点、需要审计与权限体系",那已经超出本 SOP 的设计边界,需要另一套架构(引入 ORM/迁移工具/OAuth 自助授权/持久化任务队列/多租户数据隔离),不要在这套单租户系统上硬堆这些能力。使用本 SOP 的 Agent 在实现细节上遇到本文未覆盖的情况,应优先保持"简单、幂等、单人可维护"的原则,而不是引入不必要的抽象。
SEO Agent 会成为企业网站的新基础设施
SEO Copilot 的价值,并不只是开发了一套工具,更重要的是它代表了一种新的企业 AI 应用模式。过去企业使用 SaaS 工具,工具提供固定功能和固定分析方式,企业需要适应工具。未来企业可以利用 AI Agent,根据自己的业务需求打造自己的数字化系统。
1. SEO 工作方式正在改变
过去 SEO 人员的工作是查看数据、发现问题、制定方案、执行优化;未来 AI Agent 会持续监控、发现异常、分析原因并提出建议。人的角色从数据整理者变成策略决策者。
2. 企业真正需要的是自己的数据智能
未来竞争不仅是谁拥有更多内容,而是谁更快理解自己的数据。企业网站每天都会产生大量信息:搜索行为、用户行为、转化数据和内容变化。如果这些数据只是存储,它们没有价值,只有通过数据分析、AI 理解和自动执行,才能成为企业增长资产。
3. AI Agent 不会替代 SEO,而会重新定义 SEO
SEO 本质一直没有改变:理解用户需求、创造有价值内容、解决搜索问题。变化的是执行方式。过去一个 SEO 专员管理有限数据,未来一个 SEO 专员可以拥有一个全天候工作的 AI 团队。
总结
这套 SEO Copilot 的开发过程,本质上不是开发一个 SEO Dashboard,而是探索企业如何利用 AI Agent,把自己的数据资产转化为持续增长能力。
整个系统的核心并不在于某一个技术组件,不是 BigQuery,不是 LLM,也不是 Dashboard。对于跨境企业来说,未来最有价值的 AI 应用,未必是一个通用的大平台,而可能是一系列围绕自身业务定制的小型智能系统。SEO Copilot,只是其中一个案例。
KEY TAKEAWAY 核心结论
真正重要的是将企业业务理解、数据资产和 AI 能力连接起来,这也是这类企业 AI 应用和直接用 ChatGPT 的区别所在。
如果你对这类企业 AI 应用感兴趣,可以看另一篇案例:企业 AI 应用落地案例:如何开发一套 AI Agent 驱动的自动化获客系统。
每周四送达。
主机评测、建站对比、性能优化技巧和插件推荐 — 每周为 WordPress 站长和建站者精选。