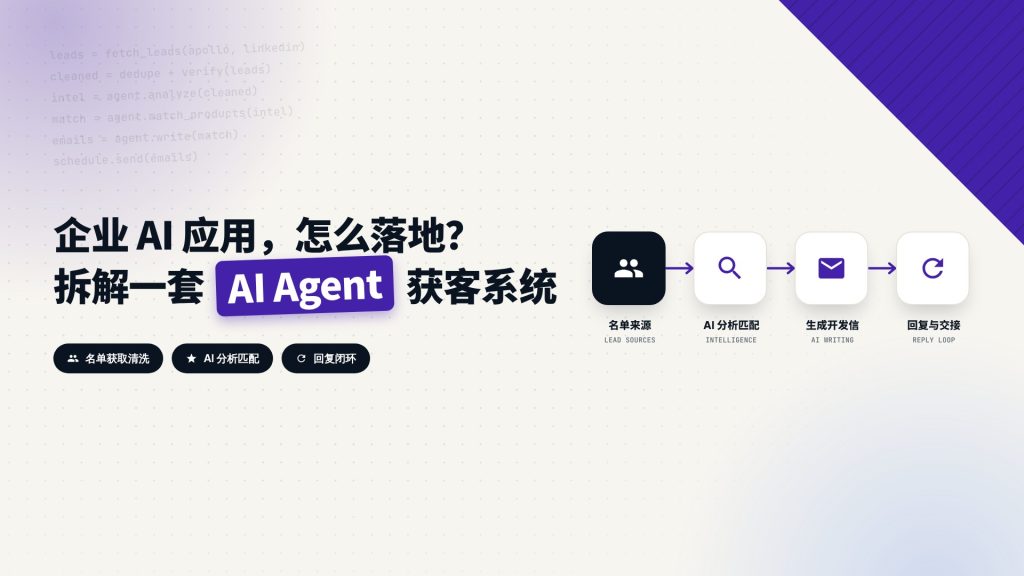
这篇文章拆解一套 AI Agent 驱动的自动化获客系统从设计到落地的全过程:名单获取与清洗、企业知识库、AI 客户分析与产品匹配、邮件生成与发送基础设施、回复闭环,以及用 Codex 和 Claude Code 交付复杂 AI 系统的方法与关键经验。文末提供完整开发 SOP,可供参考,也可直接投喂给 Codex、Claude Code 等编码 Agent 作为开发指引。
为什么企业需要重新思考获客流程?
过去几年,大量企业开始积累自己的数字资产:CRM 客户数据、历史询盘、展会名单、网站访客、产品资料。这些数据真实存在,却没有自动转化为业务机会。另一边,新客户开发仍然高度依赖人工:搜索目标企业、研究客户背景、找联系人、写开发邮件、跟进回复,每一步都靠人肉完成。
企业获客因此卡在两个效率瓶颈上:存量客户不知道怎么激活,增量客户找不到持续的精准来源。这篇文章记录的是我们设计的一套 AI Agent 驱动的自动化获客系统,目标不是做一个自动群发工具,而是让 AI 参与整个销售开发流程,把上面两条路径都变成可运行的管道。
一、系统目标与整体架构
这套系统的定位是一条完整的外联管道:Lead Generation + Customer Intelligence + Outreach Automation Pipeline,也就是线索获取、客户情报和外联自动化三个能力合在一起。线索从名单来源进入系统,经过清洗、分析、产品匹配,最后落到邮件生成、发送调度和回复跟踪,全程不需要销售手动搬运数据。
整体流程可以画成八个环节:
整体流程:从名单到销售交接
Lead Sources
多渠道名单来源
→
Data Processing
去重、验证、清洗
→
Customer Intelligence
AI 分析客户业务
→
Product Matching
判断可能的采购需求
AI Content Generation
批量生成开发信
→
Email Scheduling
限速与发送窗口
→
Reply Detection
IMAP 轮询回复
→
CRM / Sales Handoff
转入人工跟进
从工程上看,这八个环节可以归纳成五层:数据采集层负责把名单收进来,数据处理层负责清洗和富化,AI 推理层负责分析客户和生成内容,自动执行层负责调度、发送和状态管理,反馈闭环层负责把回复和退信送回系统。后面几节会按这个顺序展开每一层怎么设计。
二、潜在客户数据获取:从人工搜索到自动化名单生成
1. 为什么数据获取是第一步?
很多人以为 AI 获客的第一步是写邮件,实际恰恰相反,第一步永远是找到正确的人。如果输入的数据是错的,AI 生成能力越强,错误规模就越大:系统会给不相关的公司发三千封精心写好的开发信,每一封都精准命中错误对象。所以整套系统最先要建立的不是写信能力,而是 Lead Pipeline,一条干净的、可扩充的名单管道。
2. 新客户数据——自动化抓取工具
新客户开发的名单来源有几条路:Apollo 这类 B2B 联系人数据库、LinkedIn Sales Navigator、Serper 和 Google Search API 这类搜索接口,以及针对特定行业自建的爬虫。这个项目里 Apollo 是名单主来源,再叠加其他渠道补充。
推荐阅读:把 Apollo 邮件营销从注册配到自动发信,完整步骤在这里。
搜索不是拿一个关键词漫天撒网,而是用结构化条件圈定目标,通常组合五个维度:
- Country 目标市场国家
- Industry 所属行业
- Company Size 公司规模
- Job Title 联系人职位
- Keyword 业务关键词
举个例子,一家做汽车改装件的企业想开发美国市场的采购客户,筛选条件大概是这样:
| 筛选维度 | 取值 |
|---|---|
| Country | United States |
| Industry | Automotive Aftermarket |
| Job Title | Purchasing Manager / Engineering Manager / Owner |
跑完搜索,系统拿到的不只是邮箱地址,而是完整的联系人记录:公司名称、官网、联系人姓名、职位、Email、LinkedIn 主页。这些字段后面都会变成 AI 分析客户的输入,所以这一步宁可多抓几个字段,也不要只存一个邮箱。
3. 老客户数据——CRM系统
上面的搜索流程解决的是新客户来源,老客户线索在系统里是另一条完全独立的管道,源头不在外部渠道,而在 CRM 的存量数据里。所谓沉睡客户,通常指两类人:曾经来咨询过、报过价但一直没成交的,以及成交过一两次、之后很长时间没有继续复购的。这些客户不需要搜索和筛选,他们已经躺在系统里,问题是怎么重新激活。
沉睡客户的名单富化比新客户多一项关键内容:除了公司、联系人、行业这些基础字段,每一行还必须带上曾经的交易和沟通记录。最理想的状态是完整的时间线记录,能还原每一次咨询、报价、成交和后续沟通的先后顺序;如果 CRM 里的数据做不到这么细,至少要整理出一条过往记录摘要,把关键事实浓缩进去:客户问过什么产品、报价多少、最后卡在哪一步、成交过什么、大概什么周期采购。没有这些信息,后面的 AI 分析和邮件生成都无从下手。
4. 数据清洗与富化
原始名单不能直接喂给 AI,中间必须过一遍清洗。去重是为了避免同一个客户被重复触达,邮箱验证用来过滤无效邮箱、info 这类通用邮箱和高风险邮箱,剩下的记录还要补上公司信息:通过官网、Serper API 或企业数据库,把公司主营、产品方向、行业这些背景字段填完整。老客户记录在清洗时还要单独核对交互历史字段,确保每一条都带着时间线或过往摘要进入下一步。
清洗和富化完成后,Lead Database 按新客户和老客户分别组织。新客户数据记录 target client 和 main products & service;老客户数据保留这些字段,并增加 purchase & request records,供 AI 判断后续跟进策略。
{
  "company": "Motorsport Suspension Manufacturer",
  "contact": "[email protected]",
  "industry": "Automotive Aftermarket",
  "country": "United States",
  "website": "https://example.com",
  "business_summary": "Designs and builds suspension systems for motorsport and performance vehicles",
  "target client": "Automotive aftermarket manufacturers and distributors",
  "main products & service": ["Rod Ends", "Spherical Bearings", "Linkage Components"],
  "customer_type": "new"
}

{
  "company": "Motorsport Suspension Manufacturer",
  "contact": "[email protected]",
  "industry": "Automotive Aftermarket",
  "country": "United States",
  "website": "https://example.com",
  "business_summary": "Designs and builds suspension systems for motorsport and performance vehicles",
  "target client": "Automotive aftermarket manufacturers and distributors",
  "main products & service": ["Rod Ends", "Spherical Bearings", "Linkage Components"],
  "purchase & request records": ["Asked about rod ends in March 2025; quote sent", "Purchased spherical bearings in June 2025"],
  "customer_type": "existing"
}
三、给 AI Agent 建立企业知识库:像培训新员工一样培训 AI
这一节是整套系统里最重要的设计之一。很多人用 AI 做业务失败,原因不是模型不够强,而是 AI 根本不知道你的业务:不知道公司卖什么、优势在哪、什么客户不能接。指望模型凭通用知识替你写开发信,等于让一个没参加过培训的新销售直接去谈客户。
1. 不直接 Prompt,而是建立 Business Context
我们的做法是先准备一份企业知识文档 company-profile.md,把销售需要知道的业务背景全部结构化写进去:公司介绍(成立时间、企业定位、生产能力、服务市场),产品资料(产品分类、技术参数、应用场景),认证资质(ISO、RoHS、SGS 等),客户案例(服务行业、应用案例、合作模式),还有商业规则(MOQ、Lead Time、Payment Terms、Sales Style)。
| 知识板块 | 包含内容 |
|---|---|
| 公司介绍 | 成立时间、企业定位、生产能力、服务市场 |
| 产品资料 | 产品分类、技术参数、应用场景 |
| 认证资质 | ISO、RoHS、SGS、行业认证 |
| 客户案例 | 服务行业、应用案例、合作模式 |
| 商业规则 | MOQ、Lead Time、Payment Terms、Sales Style |
这个过程实际上是在给 AI Agent 做一次入职培训。新销售入职不会第一天就去联系客户,他会先搞清楚三件事:公司是谁、卖什么、优势是什么。AI Agent 也一样,prompt 写得再好,都不如让它先把 company-profile.md 读完,再开始碰客户数据。
Key Takeaway 核心结论
AI Agent 的能力上限由它对业务的了解程度决定。先建立企业知识库,再谈 Prompt,是这套系统能落地的第一前提。
四、AI 客户分析与产品匹配
从“生成邮件”升级到“销售判断”
传统邮件自动化的逻辑是套模板:Customer Name 加一个 Template,等于一封邮件,换的只是抬头和公司名。AI 系统的输入完全不同,它拿到的是客户业务、行业、产品应用场景和企业知识库,输出也不是一封邮件,而是一条外联策略:这个客户值不值得联系、可能需要什么产品、第一封信用什么角度切入。
| 对比项 | 传统邮件自动化 | AI 系统 |
|---|---|---|
| 输入 | 客户姓名 + 固定模板 | 客户业务 + 行业 + 产品应用 + 企业知识库 |
| 输出 | 一封套模板邮件 | 外联策略(含推荐产品与切入角度) |
| 客户粒度 | 汽车行业客户 | 具体到可能的采购品类 |
| 核心问题 | 我们想卖什么? | 客户为什么可能需要我们? |
用项目里一个真实场景说明。客户是一家 Motorsport Suspension Manufacturer,也就是赛车悬挂系统制造商。AI 分析完它的业务和产品后,推断出的潜在需求不是笼统的“汽车行业客户”,而是 Rod Ends、Spherical Bearings、Linkage Components 这些具体的悬挂连接件品类,然后针对这些品类写开发信。
老客户的分析要在新客户这套逻辑上多一层输入:历史记录。对新客户,AI 看到的是公司业务和可能的需求;对老客户,AI 拿到的还有完整的交易与沟通时间线,或者至少一份过往记录摘要,分析的问题也随之改变。新客户要回答的是“他需不需要我们的产品”,老客户要回答的是“上次为什么没谈成,这次有什么新机会能重新打开话题”,或者是“他买过一次之后为什么停了,现在是不是到了复购窗口”。同样是推荐产品,老客户的推荐要建立在历史采购品类之上,而不是从零推断。
这套判断的核心逻辑只有一句话:不是“我们想卖什么”,而是“客户为什么可能需要我们”。想清楚这一点,AI 写出来的内容才有相关性,邮件才不会一进收件箱就被当成垃圾营销。
五、核心架构设计:AI 负责判断,程序负责执行
这是企业级 AI 系统和普通 Agent Demo 最大的区别。很多 Demo 让 Agent 自主执行所有事情,看起来聪明,但生产环境不能这么干:它会自己决定发送节奏,自己改数据,出了问题没人知道在哪一步。企业系统需要控制,所以架构上把系统切成两层。
AI Layer 负责需要理解力的工作:理解客户、给客户分类、做产品匹配、生成邮件内容、分析回复。这一层可以按任务切换模型,比如用 Claude 或 GPT 做复杂推理,用 DeepSeek 跑批量生成。
Execution Layer 负责确定性工作:调度、API 调用、状态管理、数据写入、邮件发送,这一层用 Python 的 Scheduler、Worker 和 Database 实现,逻辑必须完全可预期。
| 对比项 | AI Layer | Execution Layer |
|---|---|---|
| 职责 | 理解客户、分类、产品匹配、生成内容、回复分析 | 调度、API 调用、状态管理、数据写入、邮件发送 |
| 实现 | Claude / GPT / DeepSeek | Python Scheduler / Worker / Database |
| 特质 | 需要灵活 | 需要确定 |
| 决策边界 | 可以判断“这个客户值得联系” | 决定“今天发多少封、什么时间发” |
为什么这样切?因为 AI 擅长的是开放问题,业务系统需要的是确定性。AI 可以判断“这个客户值得联系”,但不能决定“今天发送 500 封邮件”。发送量、发送时间、失败重试这些硬约束必须由程序层执行,AI 只负责在边界内做判断,这是整套系统稳定运行的基础。
六、邮件生成系统设计
1. AI 离线生成,而不是实时生成
常见的错误设计是发送时实时调用 AI:发一封,调一次模型,再发下一封。生产环境不推荐这么做,响应慢、成本不可控,而且内容完全没有审核机会。我们采用的是离线批量生成:名单先统一过一遍 AI,生成结果进入人工审核,审核通过才进发送队列。
邮件生成链路:先批量生成,再人工审核
Lead Database
清洗后的名单
→
Batch AI Generation
统一批量生成
→
Human Review
抽检与修改
→
Sending Queue
进入发送队列
离线批量生成带来的四个好处正好对应生产环境的诉求:内容可审核,销售负责人能在发送前看到每一封信;可修改,发现口径不对可以整批调整再放行;成本低,批量调用模型比逐封实时调用便宜得多;系统稳定,发送流程不依赖模型接口的实时可用性。
2. 邮件生成规则
开发信的生成规则在系统里是写死的约束:纯文本格式、内容短、单一 CTA、不用营销词。纯文本和短内容是为了送达率和可读性,单一 CTA 让收件人只做一件事,不用营销词是为了避免触发垃圾邮件过滤。
每次生成时,AI 的输入是三条:Customer Profile(客户档案)、Company Knowledge(企业知识库)、Product Match(产品匹配结果);如果目标是老客户,还会追加一条 Interaction History(历史交易与沟通记录)。输出则包含四部分:Subject、Body、Reasoning 和 Recommended Product。Reasoning 是这条记录里 AI 判断客户值得联系的推理过程,Recommended Product 是它推荐主推的产品。这两列不是给收件人看的,是给人工审核和后续分析用的。
针对老客户的邮件,生成规则要加一条硬约束:正文必须引用具体的过往记录。线下销售跟进老客户时,开口永远是“您去年采购过我们的 Rod Ends,最近使用情况怎么样”,或者“您之前咨询过我们的悬挂连接件,不知道现在是否还在考虑”,不会把对方当陌生人重新自我介绍。AI 生成老客户邮件也是一样,要基于 Interaction History 提到采购过的产品、咨询过的问题或者上次沟通停在哪一步,收件人才会意识到这封信是专门写给他的,而不是批量群发。
七、邮件基础设施设计
冷邮件系统最容易失败的地方不是 AI,而是发送基础设施。内容写得再好,进不了收件箱等于零,而进垃圾箱只需要一次错误的配置。
工具架构
| 组件 | 用途 |
|---|---|
| Mailgun | 邮件发送 API |
| IMAP | 读取回复邮件 |
| SPF / DKIM / DMARC | 域名认证,进收件箱的前提 |
| Dedicated Domain(专用域名) | 隔离发信域名,保护主域名信誉 |
| VPS | 让系统 24 小时长期运行 |
邮件协议和送达验证是两个容易踩坑的点。IMAP、POP、SMTP 各自负责什么,决定了邮件客户端怎么收发信,这套系统的回复检测就依赖 IMAP 读取,可以看这篇 什么是 IMAP、POP、SMTP;正式发信前,最好先给测试邮箱发一封验证信,确认不会进垃圾箱再放量,判断方法在这篇 我靠 Gmail Authentication-Results 判断测试信会不会进垃圾箱 里。
这套架构里最值得说的一点是专用域名。发信域名和主域名分开,即使发信域名被邮件服务商标记,也不会拖累官网邮箱。SPF、DKIM、DMARC 三条 DNS 记录在发信前就必须配好,具体配置方法可以看我们写的这篇 SPF、DKIM、DMARC 配置教程。
Mailgun 的发信域名要在后台单独添加,再按 Sending、Tracking、Authentication 三类记录把解析配到子域名的 DNS 里,验证通过后创建 sending key 交给系统调用。完整步骤可以看这篇 如何设置 Mailgun 的发信域名。
邮箱信誉控制
新邮箱直接满负荷发送,基本等于自杀。信誉控制是发送调度层最重要的设计,四个参数缺一不可:Warm-up(逐步提高发送量)、Sending Limit(每日上限)、Random Interval(发送间隔随机化)、Time Zone Delivery(按收件人当地时间发送)。
上面这些参数约束的都是单个邮箱账号。如果业务需要每天发出几百封,正确做法不是拉高单个账号的上限,而是横向扩展:配置多个不同子域名的邮箱账号,比如 mail1.example.com、mail2.example.com 各自建一个发件邮箱。每个账号仍然从自己的热身阶梯开始,分别遵守每日上限和随机间隔,子域名之间的信誉相互隔离,即使某一个账号被邮件服务商标记,也不会拖累主域名和其他账号,系统的总发送量靠账号数量叠加上去。
新邮箱的发送量按天阶梯上升,项目里用的是下面这个节奏:
| 阶段 | 每日发送上限 |
|---|---|
| Day 1 – 3 | 10 封 / 天 |
| Day 4 – 7 | 20 封 / 天 |
| Day 8 – 12 | 35 封 / 天 |
| Day 13 之后 | 50 封 / 天 |
风险提示 Warning
邮箱热身阶段不能跳级。新邮箱第一天就发几百封,域名信誉会立刻被邮件服务商标记,后面再想恢复要付出几倍的代价。
八、回复闭环设计
发送不是终点,回复才是。一封开发信发出去之后,系统必须能回答三个问题:这是真人回复、自动回复还是退信?
回复处理闭环
Email Sent
开发信已发出
→
IMAP Monitoring
轮询收件箱
→
Reply Classification
AI 判断回复类型
Stop Sequence
停止后续跟进
→
CRM Update
状态回写系统
→
Sales Follow-up
销售接手跟进
回复分类由 AI Layer 处理:检测到真人回复,立刻停止这条线索的后续跟进序列,并把状态更新到 CRM,交给销售接手;检测到自动回复(比如 out-of-office),继续序列,等对方回来再跟进;检测到退信,把地址放进 Suppression List,系统以后不再向这个地址发送任何邮件。
九、技术栈与成本
整套系统的技术栈没有用冷门框架,全部是成熟组件,按用途分四块:
| 类别 | 工具 | 在这个系统里的分工 |
|---|---|---|
| AI 开发工具 | Claude Code / Codex | 架构设计、代码生成、Debug、部署 |
| AI 模型 | Claude Opus | 系统设计、复杂推理 |
| AI 模型 | DeepSeek | 批量邮件生成、大规模任务 |
| 数据工具 | Apollo | 客户名单获取 |
| 数据工具 | Serper API | 企业信息补充 |
| 邮件服务 | Mailgun | SMTP / API 发送、Tracking、Bounce 处理 |
| 部署 | VPS + Docker | 长期运行、环境隔离 |
开发这整套系统,核心开发工作由 AI 编码工具完成:用 Claude Code 或 Codex 做架构设计、生成代码和调试,开发者负责拆任务、写约束和验收结果。模型选择上按任务分级,复杂推理用 Claude Opus,跑批量邮件生成这类大规模任务用 DeepSeek,成本能压到很低。
把 Claude Code 和 Codex 当主力开发工具,订阅和账号稳定性是前提。付款方式上,没有信用卡也能订阅,具体做法可以看这篇 无需信用卡,也可以订阅 ChatGPT 和 Claude Code;账号长期高强度使用存在被风控的风险,怎么规避可以参考这篇 如何降低 Claude Code 账号异常风险。
跑系统本身不需要昂贵的机器,一台 2 Core、2GB 内存、Ubuntu 24.04 的 VPS 加 Docker 就够了,这类长期运行的项目,Hostinger 的 VPS 从配置到价格都比较合适。
购买好 VPS 后,建议为其配置SSH Key 登录。
十、Agent 项目开发方法:如何让 Codex 和 Claude Code 完成复杂系统
这种规模的系统,不能指望丢一句”帮我做一个邮件系统”就让 AI 写完。大型 AI 开发项目的正确打开方式,是先建立一套项目文档,让 Agent 拥有长期上下文。项目目录一开始就是固定的结构:
project/
├── BRAINSTORMING.md
├── PLAN.md
├── CLAUDE.md
├── PROGRESS.md
├── TODO.md
└── .env| 文件 | 记录什么 |
|---|---|
| BRAINSTORMING.md | 业务目标,为什么要做这套系统 |
| PLAN.md | 开发计划,按什么顺序推进 |
| CLAUDE.md | 项目规则,Agent 必须遵守的约束 |
| PROGRESS.md | 当前状态,做到哪一步了 |
| TODO.md | 待办事项,下一步要做什么 |
| .env | 环境变量与密钥,不进入版本库 |
这几份文档的价值在于,每次新开会话,Agent 读一遍 PROJECT 状态就能接着上次的进度干活,不需要从零回忆。尤其是 CLAUDE.md,把前面几节讲的红线(发送节奏、人工审核、禁止 AI 自主决定发送量)写成项目规则,Agent 在开发过程中就会自动遵守。
我们把这套系统实际走过的完整工程过程——从铁律清单、分阶段验收标准,到踩过的坑和开源前的安全检查表——重新整理成了一份可以直接开源、直接投喂给 Codex / Claude Code 等编码 Agent 的 SOP,共 7 份核心开发文件(00–06)。下面按各章节贴出这 7 份文件的正文,你可以直接复制到自己项目的 /SOP 目录,让 Agent 按这套规格从零构建出同一套逻辑的系统。
00-README.md — 如何使用这套 SOP:两种模式共享同一条流水线
# 自动化邮件营销系统 — SOP 索引

## 目的

本SOP集合规定了如何构建**一套统一的自动化邮件营销系统**,在同一条流水线上支持两种运行模式:

| 模式 | 描述 |
|---|---|
| `cold_outreach` | 面向新客户的冷开发,名单来自采购/抓取/富化的联系人数据。 |
| `reactivation` | 对曾经询盘但未成交的休眠客户进行二次激活,数据来自内部CRM/历史询盘记录。 |

两种模式共享约90%的相同架构(数据层、AI写信引擎、发送调度、回复闭环、报表、部署)。本SOP的写法是让自主编码Agent(如 Claude Code、Codex CLI)可以直接逐阶段执行,不需要额外的叙事性讲解。

## 文件索引

| 文件 | 内容 |
|---|---|
| `01-infrastructure-and-accounts.md` | 工具、账号、VPS、DNS、邮箱、密钥清单 |
| `02-lead-data-schema.md` | 名单必备字段、数据库表结构、导入校验规则 |
| `03-development-sop.md` | **核心规格。** 铁律 + 分阶段开发计划(P0–P8) |
| `04-reactivation-variant-spec.md` | `reactivation` 模式相对基础流水线的差异规格 |
| `05-security-compliance-guardrails.md` | 密钥管理、合规要求、开源前检查清单 |
| `06-troubleshooting-reference.md` | 症状→根因→解法速查表 |

## Agent应如何使用本SOP

1. 先读 `03-development-sop.md` — 其中的铁律适用于所有阶段。
2. 先完整构建 `cold_outreach` 模式(P0→P8),再叠加 `reactivation` 模式。
3. 构建 `reactivation` 模式时,把 `04-reactivation-variant-spec.md` 作为在已构建流水线上的差异叠加,不要复制出第二套代码库。
4. 每个阶段都需要有证据的验收(打印表格、可审阅文件、DB状态对比),产出证据前不得进入下一阶段,不要仅凭自我判断"完成了"。
5. 全程在仓库根目录维护三份文档:`AGENTS.md`(事实+铁律)、`PLAN.md`(分阶段计划)、`PROGRESS.md`(已完成内容、决策、修复记录)。每个阶段结束都要更新 `PROGRESS.md`。
6. 仅在遇到本SOP未覆盖的真实业务决策时才停下来询问操作者(例如具体行业的产品目录内容、选用哪家ESP/LLM厂商、目标发送量)。本SOP已规定的实现细节不需要再次请示。

## 范围说明

这是一套用于从零开始通用构建该系统、并对外开源的规格文档。文档中不含任何真实公司名称、域名、密钥或生产环境统计数据 — 所有示例均使用占位符(`yourcompany.com`、`[email protected]` 等)。任何人按照本SOP操作,都应能为自己的业务独立搭建出一套实例。
01-infrastructure-and-accounts.md — 开发前要备齐的账号、域名、DNS 与密钥
# 基础设施与账号清单

以下所有项目都必须在开始P0阶段(见 `03-development-sop.md`)之前准备好/配置好。这些步骤都不需要深厚的技术背景 — 大部分工作是在服务商网页控制台里完成的。

## 本地开发工具

| 工具 | 用途 |
|---|---|
| AI coding agent (Claude Code, Codex CLI, or equivalent) | 执行本SOP、编写代码、运行命令 |
| Terminal | 与编码Agent交互的界面 |
| Python 3.11+ | 系统运行环境 |
| Git | 版本控制/存档点 |
| Docker + Docker Compose | 部署打包(P7阶段用) |

## 发送域名与DNS

**铁律:绝不用公司主域名发送冷邮件/营销邮件。** 使用隔离的子域名,或一个专用于外发邮件的独立域名。

```
主域名,绝不用于发信
发送子域名1
发送子域名2
随发送量增长追加子域名
```

每个发送域名的要求:

- DNS管理权限(Cloudflare 或注册商自带DNS面板)
- 已配置 SPF 记录
- 已配置 DKIM 记录(由邮件服务商提供,见第3节)
- 已配置 DMARC 记录
- 该域名下已开通一个支持IMAP的真实邮箱(见第4节)

规模参考:一个热身完成的邮箱稳态大约每天可安全发送50封。如果目标是每天约300封,需要规划约6个发送域名/邮箱。按比例扩展即可。

## 邮件发送服务

不要自建邮件服务器 — IP信誉、退信处理、黑名单监控、发送限流这些工作自己维护成本很高。使用托管的邮件发送服务。

| 选项 | 说明 |
|---|---|
| Mailgun | 本SOP的参考实现;中等发送量约$35/月档位即可 |
| SendGrid / Postmark / Amazon SES | 可替代方案 — 只需替换发送函数实现 |
| Direct SMTP via mailbox provider | 也可用邮箱自带SMTP,但需自行实现退订链接和退信统计 |

清单:

- 已创建ESP账号
- 每个发送域名已在ESP中添加并**验证通过**(DNS检查全绿)
- **每个域名使用其自己的域名级"sending key"** — 绝不用跨域名共享的账户级API key。用错key会导致隐蔽且不一致的按域名失败。
- 已开启 `tracking-unsubscribes`(或等效的List-Unsubscribe自动化功能)
- 已了解新账号观察期/限流机制(新ESP账号通常在获得信任前,每域名每小时上限约100封)

## 收件(回复)邮箱

每个发送邮箱都需要一个真实的收件箱接收回复。**发件地址、Reply-To地址、被IMAP轮询的收件箱必须是同一个地址** — 否则回复会落到没人看的地方。

- 邮箱服务商支持IMAP(任何标准企业邮箱都可以)
- 每个邮箱的IMAP主机、端口、用户名、密码已记录
- 成本参考:约每邮箱每月$1

## AI与数据服务

| 服务 | 用途 | 适用模式 |
|---|---|---|
| LLM API for bulk email generation | 用于批量写信的低成本高吞吐模型(如DeepSeek级别定价) | 两种模式 |
| Stronger LLM for development | 编码Agent自身用来开发系统(如Claude Opus级别) | 仅开发阶段 |
| B2B contact database (e.g. Apollo.io) | 采购新客户联系人名单 | `cold_outreach` only |
| Web-search / SERP enrichment API (e.g. Serper) | 补充联系人记录中"这家公司实际卖什么"这类信息,因为联系人数据库通常这部分较薄弱 | `cold_outreach` only (optional) |

注:`reactivation` 模式不需要采购联系人数据 — 名单来自你自己的CRM/历史询盘记录。

## VPS(生产部署)

- 开发阶段不需要 — 先在本地构建和测试。
- 生产环境最低配置: 1–2 vCPU, 2–4GB RAM, Ubuntu 24.04 LTS.
- 已配置SSH密钥登录(禁用密码登录)
- 已安装 Docker + Docker Compose

## 密钥存储约定

- 所有凭证只放在 `.env` 文件中,绝不写入代码。
- `.env` 从**第一次提交**起就在 `.gitignore` 中。
- 提交一个仅含占位符值的 `.env.example` 模板,用于说明每个必需的key。
- 完整密钥策略见 `05-security-compliance-guardrails.md`。

## 成本参考(量级)

| 类别 | 一次性 | 每月 |
|---|---|---|
| 域名与子域名 | ~$10 | — |
| ESP(Mailgun级别) | — | 按用量 |
| 收件邮箱×N | — | ~$1 × N |
| 批量生成LLM API | 一次充值可用较久 | 可忽略 |
| VPS | — | 视配置 |
| B2B联系人数据库(仅冷开发) | — | ~$99 |
| SERP富化API(可选) | ~$50 credit | — |

以上为示意性区间,非报价 — 请以各服务商当前定价为准。
02-lead-data-schema.md — 名单字段规范与数据库表结构
# 名单数据字段规格

## 基础字段(两种模式通用)

| 字段 | 是否必需 | 用途 |
|---|---|---|
| `email` | ✅ Required | 唯一标识,去重依据,导入时统一转小写 |
| `first_name` | ✅ Required | 邮件正文中的称呼 |
| `company_name` | ✅ Required | 用于标题和正文 |
| `country` | ✅ Required | 决定发送时段的时区换算 |
| `category` / `industry` | 强烈建议 | AI匹配产品/服务时的主要依据 |
| `business_intro` | 强烈建议 | AI个性化写信的支撑信息 |
| `main_products` / `main_interest` | 强烈建议 | 同上,该字段质量越高,信写得越准 |
| `job_title` | 可选 | 措辞参考 |

**原则:名单质量比数量重要。** 500条字段完整、邮箱已验证的联系人,胜过5000条只有邮箱地址的联系人 — 后者AI没有素材可以个性化。

## `reactivation` 模式追加字段

| 字段 | 是否必需 | 用途 |
|---|---|---|
| `inquiry_summary` | 有则必需 | 该客户此前具体询问过什么(一两句话),是本模式写信最核心的支撑信息 |
| `owner` | ✅ Required | 负责该客户的业务员;决定用哪个邮箱发信、回复归属给谁 |
| `customer_code` | 建议 | CRM客户编号,用于把回复对回CRM系统 |

如果源文件没有 `owner` 列,按已知业务员名单做均衡轮询分配。

这些字段如何影响写信和路由逻辑,见 `04-reactivation-variant-spec.md`。

## 导入校验规则(Agent必须实现)

1. **邮箱归一化**:转小写、格式校验;非法邮箱跳过并计数,不能静默丢弃。
2. **幂等导入**:同一文件导入两次,第二次必须产生零新增。
3. **非破坏性合并**:对已存在的联系人,只补空字段,绝不用新数据覆盖已有非空字段。
4. **导入时抑制名单检查**:已在 `suppression` 表中的邮箱,任何新名单导入都不得让其重新进入发送流程("不复活"原则)。
5. **增量导入目录**:提供一个投放目录(如 `lists/`),放入新文件即可导入,不影响已导入数据。
6. **跨文件去重(仅reactivation模式)**:同一邮箱可能出现在多个业务员的源文件中;按邮箱全局去重,只保留一个 `owner` — 绝不能让同一客户收到两个业务员发来的重新联系邮件。冲突处理规则:保留发送进度最深的那条记录。
7. **排除规则必须用结构化字段,不能用模糊名称匹配。** 例如按 `category == "higher_education"` 排除,绝不能按"公司名含'college'"排除(真实反例:公司名为"College Park Industries"的其实是一家医疗器械公司,不是大学)。
8. 每次导入后**输出对账统计**:`新增 + 重复 + 非法 + 被抑制 ≈ 源文件总行数`(Agent必须能解释任何差异)。
9. **批量生成前的数据质量抽查**:任何批量AI生成前,随机抽样≥20行,人工核实 `main_products`/`inquiry_summary` 确实描述的是该客户自己(富化/CRM数据可能被污染 — 例如富化流程的bug把己方产品填进了对方字段)。

## 数据库表结构(推荐SQLite)

SQLite足以支撑数万级名单、数十万级邮件量 — 它是单个文件,备份即复制文件,不需要单独的数据库服务器。只有规模确实需要时才迁移到客户端-服务器数据库。

| 表 | 存的是什么 | 关键字段 |
|---|---|---|
| `leads` | 每行一个联系人 | `email` (unique), base + mode-specific fields above |
| `sequences` | 每个客户的邮件序列 | status: `draft` / `active` / `cancelled` / `completed` |
| `emails` | 序列中每一封具体邮件 | subject, body, step number, scheduled_at, status: `pending`/`sent`/`cancelled` |
| `replies` | 收到的回复 | `is_auto_reply` flag |
| `suppression` | 永久黑名单 | reason: `replied` / `unsubscribed` / `bounced` / `no_fit` |
| `send_log` | 每真实发出一封记一行 | used to compute daily counts and warmup progress |
| `imap_baseline` | 每个邮箱首次轮询时的起始UID | prevents historical mail from being misread as new replies |

`reactivation` 模式在 `leads` 表中增加 `owner`、`customer_code`、`inquiry_summary`,并在报表层增加 `owner` — 见 `04-reactivation-variant-spec.md`。
03-development-sop.md — 核心规格:19条铁律 + 分阶段构建计划 P0–P8
# 开发SOP — 核心构建规格

这是主执行规格。先完整构建 `cold_outreach` 模式(P0→P8),再把 `04-reactivation-variant-spec.md` 作为差异叠加到同一条流水线上。

---

## 铁律(适用于所有阶段)

这些规则存在的原因是:一旦违反其中任何一条,损害都是不可逆的(发出的邮件无法撤回,域名信誉无法快速重建,被烧掉的客户无法再次接触)。要在事故发生之前实现它们,而不是事后补救。

| # | 规则 |
|---|---|
| 1 | 绝不用公司主域名发送。只用隔离的发送子域名/独立域名。 |
| 2 | 每个发送域名必须在正式发送前完成SPF、DKIM、DMARC验证。DKIM缺失/错误会导致送达率悄悄下降且没有任何报错 — "发送成功"不等于"被看到"。 |
| 3 | 每个域名使用自己独立的ESP domain-level sending key。绝不跨域名共用账户级key。 |
| 4 | **内容生成与发送彻底分离。** AI只把内容写入数据库,状态为 `draft`。真正决定"发什么、发给谁、什么时候发"的是一个确定性的、基于规则的调度器/发送程序 — 绝不是运行时由LLM临时决定。 |
| 5 | 默认排练模式(dry-run)。真发必须显式打开 `SEND_LIVE=1`。dry-run必须**严格只读** — 零数据库写入。这一点必须通过对比dry-run前后的数据库状态来实测验证,不能只凭假设。 |
| 6 | 新发送邮箱需要热身阶梯(见Part C,P4阶段),按实际发信天数计算,而非日历天数 — 周末/未发信的空档天不计入热身进度。 |
| 7 | 同一公司域名每天最多联系1人,**但**个人邮箱域名白名单(gmail.com、outlook.com、hotmail.com等)豁免此规则。 |
| 8 | 排期算法采用装箱式思路:遇到同公司冲突时,只把这一个客户顺延到下一个可用日 — **绝不**因此推进整个邮箱的排期日期游标。(已知故障模式:一处错误的冲突处理逻辑会把整个邮箱的排期表拉长到数月之后。) |
| 9 | 序列节奏(`cold_outreach`):第2封 ≥ 第1封实际发送时间 + 3天;第3封 ≥ 第2封实际发送时间 + 10天。计时以实际发送时刻为准,不是原计划时刻。 |
| 10 | 任何真人回复立即取消该客户**所有**待发邮件,并把该邮箱加入 `suppression`。自动回复(假期自动回复、工单系统确认信、退信)**不得**触发取消 — 用P5阶段的三层判断规则来分类。 |
| 11 | `suppression` 名单永久生效。任何来源的后续导入,都不得让被抑制的邮箱重新进入发送流程。 |
| 12 | AI写的正文绝不能编造事实:不能编造具名的参考客户,没有询盘记录时不能编造"您之前咨询过"这类说法,任何编造数据都不允许。 |
| 13 | 批量生成前必须先出一份小样本(如20个客户,输出到可审阅文件,零数据库写入)供人工审核,通过后才能扩大规模。审核需要留下书面确认记录,不能只是口头"看着还行"。 |
| 14 | 分阶段上线:小批量试跑 → 观察真实数据 → 逐步扩大。绝不在第一次运行时就把导入+生成+排期+发送一次性跑完整份名单。 |
| 15 | 密钥只存在于 `.env`,从第一次提交起就在 `.gitignore` 中排除。代码只通过环境变量读取凭证。绝不提交密钥或 `.env` 文件本身。 |
| 16 | 任何表结构迁移、批量数据变更、进度迁移之前,先备份数据库。 |
| 17 | VPS上长时间运行的远程任务一律用 `nohup`(或进程管理器)运行,避免SSH断线杀死任务。 |
| 18 | 每个 `docker-compose` 文件都要显式设置 `name:` — 不要依赖默认的目录名项目名,它可能和同一台主机上的另一个项目撞车。 |
| 19 | 每封外发邮件都必须带 `List-Unsubscribe` 邮件头和正文中可见的退订链接。退订和硬退信要立即、自动地加入 `suppression`。 |

---

## 工作项目结构

```
project-root/
├── AGENTS.md              # facts, directory map, hard rules (agent reads this first every session)
├── PLAN.md                 # phased plan and key decisions
├── PROGRESS.md             # what's done, per-phase evidence, bugs fixed
├── company_data/            # product/service catalog, company facts, signature template (business input, not code)
├── lists/                   # drop folder for incoming lead CSV/Excel files — picked up by incremental import
├── data/
│   ├── email_marketing.db   # SQLite database
│   └── backups/             # dated DB backups
├── src/                     # application code
├── deploy/
│   ├── docker-compose.yml   # name: set explicitly (Rule 18)
│   └── .env                 # SEND_LIVE and all secrets — gitignored
├── .env.example              # documents required keys with placeholder values only
└── .gitignore                 # must exclude .env, data/*.db, data/backups/
```

`AGENTS.md`/`PLAN.md`/`PROGRESS.md` 存在的原因是编码Agent没有跨会话记忆。每次新会话都应以"读取AGENTS.md和PROGRESS.md,接续下一阶段"开始。每个重要决策和每个bug(症状→根因→修复)都要在发生时记入 `PROGRESS.md`。

---

## 分阶段构建计划

以下每个阶段都必须通过其**验收标准**(并产出指定的证据)才能进入下一阶段。

### 环境与连通性校验

- **目标**
  在编写任何应用逻辑之前,确认每个外部账号/凭证确实可用。
- **输入**
- **产出**
  一个自检脚本,对每个已配置的域名/邮箱验证:(1) ESP域名状态为 `active`;(2) IMAP能成功登录;(3) SPF/DKIM/DMARC记录能正确解析。**不发送任何邮件。**
- **验收**
  脚本打印按域名的结果表,全部行为绿色。任何红色行都要先诊断并修复才能继续(DNS问题最常见的原因是记录抄错或还未生效,最长可能需要等待24小时)。

### 项目骨架与工作文档

- 按Part B建立目录结构、配置文件,初始化 `AGENTS.md`/`PLAN.md`/`PROGRESS.md`,把Part A的铁律写入 `AGENTS.md`。
- 三份文档均已存在且非空;第一次提交前 `.gitignore` 已就位;已完成第一次git提交。

### 数据层

- 按 `02-lead-data-schema.md` 第4节建立SQLite表结构(7张表),并实现导入脚本,满足 `02-lead-data-schema.md` 第3节的全部规则。
- **命令接口**
- 统计数字与源文件行数能对上;重复导入同一文件产生 `new=0`;随机抽查3个邮箱,数据库字段与源文件原始内容完全一致。

### AI写信引擎

- 每个客户一次LLM调用,返回结构化JSON:
  ```json
  {
    "matched_categories": ["1 to 3 matched product/service categories"],
    "rationale": "one sentence, for human review",
    "used_fallback": false,
    "emails": [
      {"step": 1, "subject": "...", "body": "..."},
      {"step": 2, "subject": "...", "body": "..."},
      {"step": 3, "subject": "...", "body": "..."}
    ]
  }
  ```
  系统提示词输入:完整产品/服务目录(`company_data/`)+ 下方的写信规则。

- **匹配规则**
  1. 匹配依据是客户的真实业务需要,而非己方最想卖什么。
  2. 每个客户选1-3个真正相关的品类;全局要保持品类分布多样化,不能让所有客户都落在同一个"王牌品类"上。
  3. 应用面广的王牌品类,真正适用时仍应大方推荐 — "多样化"不等于人为压制它。
  4. 绝不硬套明显不相关的品类。改用预先定义的备选方案(如"定制方案咨询"),并在使用时标记 `used_fallback: true`。
  5. 验收信号:备选方案占比通常应低于约20%。更高的比例说明需要检查名单或产品目录,而不是放宽匹配规则。

- **正文规则**
  - 每封信≤120词,纯文本,无HTML,无表情符号。
  - 3封信定位:(1) 自我介绍+匹配品类 (2) 补充一个价值点 (3) 礼貌收尾。
  - 写到CTA就停 — **AI输出中不含签名**;签名由程序统一追加(避免重复或编造落款)。
  - 可信度信息(成立年份、认证、交期、MOQ等)可自然融入正文,但只能来自 `company_data/`。
  - 未经明确授权,绝不能点名具体真实客户作为案例;改用泛指说法(如"leading OEMs in your industry")。
  - 标题公式:产品词+业务场景词+对方公司名(自然大小写)。禁用促销词(price/free/best/discount)、特殊符号(&%$!)、全大写公司名。3封信标题要有变化。

- **确定性清洗**
  LLM输出后,通过程序自动剥离任何落款、把 `&` 替换为 `and`、去除禁用特殊字符、把全大写公司名转为首字母大写(同时保留CNC、ISO等已知缩写的大写形式)。

- `generate --sample N`(输出可审阅的markdown文件,**零数据库写入**);`generate --all`(并发执行、可中断续跑、单条失败不影响整批、写入数据库、结束时打印品类分布报告)。

- ≥20个客户的样本由人工按此清单审核 — 是否真正匹配?有无编造?标题公式是否遵守?长度/语气/称呼是否正确?备选方案占比是否合理?— 并在 `--all` 运行前于 `PROGRESS.md` 中明确签字确认。预计需要2-4轮审核才能收敛。

### 发送调度

- **配置项**

| 配置项 | 默认值 |
|---|---|
| `DAILY_LIMIT_PER_MAILBOX` | 单邮箱稳态每日上限 |
| `WARMUP_RAMP` | 热身阶梯(按实际发信天数) |
| `SEND_WINDOW_START` / `SEND_WINDOW_END` | 发送时间窗(收件人当地时间) |
| `MIN_GAP_MINUTES` / `MAX_GAP_MINUTES` | 两封信之间的随机间隔 |
| `STEP2_MIN_DAYS` / `STEP3_MIN_DAYS` | 序列跟进最小间隔天数 |
| `SAME_COMPANY_PER_DAY` | 同一公司域名每日最多联系人数 |
| `PERSONAL_DOMAIN_WHITELIST` | 个人邮箱域名白名单(豁免同公司限制) |
| `SEND_LIVE` | 0=dry-run(默认),1=正式发送 |

  - `schedule --plan`:给每个 `draft` 序列分配发送邮箱,用装箱算法计算首封发送时间(对应铁律8);热身天数从 `send_log` 历史记录接续(重新排期不会把已热身的邮箱打回第1天)。
  - `schedule --process`:由调度器每约20分钟运行一次;查找到期邮件,在真正发送时重新核对当日上限和抑制名单,通过ESP发送(带List-Unsubscribe头+退订链接),写入 `send_log`;第1封发出后,从实际发送时刻起排第2/3封;第3封发出后,序列标记为 `completed`。默认dry-run — 只有 `--live`(且 `SEND_LIVE=1`)才真正发送。
  - `schedule --show`:打印未来7天的发送计划供人工核对。

  对照Part A(§6-9)的每一条规则人工核对打印出的计划:每邮箱每日数量匹配热身阶段;无周末/非工作时段;同公司限制生效(白名单豁免);重新排期后热身进度正确接续。然后以dry-run模式运行一次 `--process`,**对比运行前后的数据库 — 必须完全一致**(证明dry-run确实只读)。

  这里还有两项**必须做、不是可选**的压力测试 —— 都是 `06-troubleshooting-reference.md`(B2、B3)中记录的真实故障模式,在此系统此前一次实际部署中,正是因为这个阶段没测到,才在上线**之后**才暴露出来:

  1. **免费邮箱域名压力测试**:给 `schedule --plan` 灌入一批个人邮箱域名(`PERSONAL_DOMAIN_WHITELIST`)客户,数量要足以在白名单豁免逻辑失效时触发 `SAME_COMPANY_PER_DAY` 限制。确认这批客户的首封发送日期仍落在正常的热身/稳态节奏内 —— 不会被推迟数月甚至数年。"代码看起来写对了,但从未拿真实数据量验证过"的白名单豁免逻辑,不算验收通过。
  2. **多状态dry-run测试**:把上面"运行前后二进制一致"的测试,至少在三种不同的起始数据库状态下各跑一次,而不只是空闲状态 —— (a) 无任何待处理事件的普通一天 (b) 存在一条待处理的真人回复 (c) 存在一个待处理的同公司排期冲突。每种状态都必须各自产出完全一致的运行前后diff。"在空数据库上dry-run确实只读,但回复处理分支或冲突分支真正执行时却写了库"是一个真实发生过的故障模式。

### 回复闭环

- 每约20分钟对所有发送邮箱进行一次IMAP轮询。
  - `reply --init-baseline`:每个邮箱在首次真正轮询前运行一次;记录当前最大邮件UID作为基线。之后只处理UID高于基线的邮件 — 防止旧邮件被误判为新回复。
  - 三层自动回复判断规则(命中任一层都不能判定为真人回复):
  - 判断结果:
    - 发件人是已知客户 + 判定为真人回复 → 写入 `replies`;取消该客户所有待发邮件;序列标记 `cancelled`;该邮箱加入 `suppression`。
    - 发件人是已知客户 + 判定为自动回复 → 写入 `replies` 并标记 `is_auto_reply=true`;**不**取消、**不**加入抑制名单。
    - 发件人不是已知客户 → 仅记录,不做任何处理(避免误伤无关系统邮件)。
  - 退信和退订事件也立即路由到 `suppression`。

- 端到端人工测试 — (1) 用自己的邮箱手动回复一封测试信,下一轮轮询后确认:回复出现在 `replies` 中,该客户待发邮件已 `cancelled`,该客户已进入 `suppression`。(2) 触发一次真实的假期自动回复,确认它被记录但**不**触发取消/抑制。

### 报表与监控

- **每日日报**
  每天固定时间发送一次,将上次运行以来的所有新回复整理为表格附件邮件发送。每行包含AI生成的一句话询盘摘要(用运营人员偏好的语言)。**即使零新回复也照常发送**("今日无新回复"的报告本身就是系统存活的心跳信号)。
- **状态看板**
  一个只绑定 `127.0.0.1` 的只读网页(绝不对公网暴露 — 通过SSH隧道访问),显示:每邮箱今日发送数/上限(及当前热身天数);排队中/已发送/已取消邮件数;最近回复;未来24小时发送计划。
- **备份**:每日cron任务将SQLite数据库文件复制到 `data/backups/`,文件名带日期后缀;保留最近30天。
- 逐字段审核一份样例日报;对照直接查询数据库的结果核对看板数字,一致;确认备份cron正常运行。

### 部署

  - 两个服务:`orchestrator`(运行调度器/回复闭环/报表的定时循环)和 `dashboard`(P6状态页,绑定 `127.0.0.1:8090` 或类似端口 — 不绑定 `0.0.0.0`)。
  - 代码和SQLite数据库以卷挂载方式挂载自宿主机 — 数据在容器重建后依然保留。
- 部署到VPS后,以dry-run模式运行24小时,零错误且所有定时任务按时触发,才能进入P8。

### 正式上线

1. 清理开发期间产生的测试数据/记录(测试发送、自己发的测试回复)— 否则会污染热身计数和报表。要求Agent报告具体清理了哪些内容。
2. 将 `deploy/.env` 中的 `SEND_LIVE` 从 `0` 改为 `1`,重建 `orchestrator` 容器。
3. 密切关注第一封真发邮件:确认它在ESP后台显示为已送达、在 `send_log` 中有记录,并且(通过给自测地址发信)确认真正落入收件箱(而非垃圾箱)。
4. 第一周不要超出热身阶梯加速发送,即使早期数据看起来不错。热身阶梯是底线,不是建议。
- 第一封真发邮件全链路可追溯(ESP + send_log + 收件箱送达);每日备份cron已确认运行;`PROGRESS.md` 中记录上线时间戳。

---

## 运维手册(上线后)

| 场景 | Action |
|---|---|
| 新增名单 | Drop the CSV/Excel file into `lists/`; picked up by the next scheduled import. |
| 暂停发送 | Set `SEND_LIVE=0` in `deploy/.env`, rebuild `orchestrator`. |
| 查看状态 | Open the dashboard via SSH tunnel, or wait for the daily digest. |
| 部署代码变更 | Sync code to server, rebuild/restart `orchestrator` container. |
| 排查异常 | Describe the observed symptom precisely (e.g. "expected 60 sends, got 3") and let the agent diagnose from logs — see `06-troubleshooting-reference.md` for known patterns. |
04-reactivation-variant-spec.md — 老客户二次激活模式的差异规格
# 二次激活模式 — 差异规格

本文件规定 `reactivation` 模式相对于 `03-development-sop.md` 中构建的 `cold_outreach` 模式的所有差异。应作为差异叠加在同一套代码库/流水线上实现 — 不要另开一个项目。约90%的流水线(数据层结构、调度器机制、回复闭环、报表机制、部署方式)保持不变、直接复用。

## 为什么值得单独做这个模式

曾经询盘但未成交的休眠客户是一项未被充分利用的资产:他们已经知道你是谁,而当年没成交的原因(价格没谈拢、时机不对、项目取消)往往已经不再成立。在相同发送量下,回复意愿通常明显高于纯冷名单 — 但前提是语气要对。如果对方察觉到这是一套"套路式重新触达",信任崩塌的速度会比毫无渊源的冷联系人更快。

## 名单来源

- `cold_outreach`:采购/抓取/富化的外部联系人数据库。
- `reactivation`:内部CRM导出数据或业务员自己的历史询盘记录 — 不需要采购数据。

## 追加字��

见 `02-lead-data-schema.md` 第2节:`inquiry_summary`、`owner`、`customer_code`。

## 写信规则差异

- **语气/结构**:把3步"介绍/补充价值/收尾"框架替换为**重新连接/温和跟进/敞开一扇门**。整体语气更低压力、更温和;CTA用柔和的开放式问句(如"worth reconnecting?"、要不要发最新目录),而非直接的成交式要求。
- **引用历史(本模式的核心差异点)**:`inquiry_summary` 有内容时,要在开头自然地引用它(如"You reached out a while back about X...")。这正是二次激活邮件效果优于冷邮件的关键,要用起来。
- **铁律 — 历史记录为空时绝不编造**:`inquiry_summary` 为空或缺失时,正文必须使用泛化的重新联系开场("we connected a while back"),**绝不能**声称"您之前咨询过X"。此时产品推荐只能以建议的口吻带出,绝不能写成"您之前问过这个"。一旦对方发现自己被编造了一段并不存在的记忆,信任会立刻、且往往永久性地崩塌 — 这是对 `03-development-sop.md` Part A 铁律12的更严格版本。
- **产品匹配依据**:优先推荐 `inquiry_summary` 中提到的品类及其紧密相关品类,而非 `cold_outreach` 模式中使用的全目录通用匹配。

## 发件路由(按owner)

- 每个业务员(`owner`)有自己专属的发送邮箱;某客户的3封信始终从**该客户`owner`对应的邮箱**发出,落款为该业务员姓名 — 绝不在多个邮箱之间轮询混发。
- 回复轮询(P5)必须覆盖**全部**owner邮箱,而不是单一共享收件箱。
- 每日日报(P6)中的"负责业务员"列 = `owner`,这样回复能直接归属到应该继续跟进的人。

## 热身

- 已有发送历史的业务员邮箱通常**不需要** `cold_outreach` 模式中新邮箱那套热身阶梯。
- 然而,如果多个 `owner` 邮箱共用同一个发送域名,**域名级别的合计日发送量**仍然是真正的风险单位(ESP通常按域名而非按邮箱做限流/观察期判定 — 见 `06-troubleshooting-reference.md`)。需要设置一个覆盖该域名下所有邮箱合计发送量的 `DOMAIN_DAILY_LIMIT`(如300-500/天),而不能只依赖逐邮箱限额。

## 序列节奏差异

- `STEP3_MIN_DAYS` = **7**(`cold_outreach`为10)— 因为已有关系基础,跟进可以更快一些。

## 跨业务员去重

同一客户可能同时出现在多个业务员的源文件中。导入时在所有源文件范围内**按邮箱全局去重**,只分配一个 `owner`。绝不能因为两个业务员各自独立的文件,导致同一客户收到两封各自独立的"重新联系"邮件 — 这会立刻、明显地暴露出这是自动化流程。

同一邮箱出现在多个文件中时的冲突处理规则:保留发送/回复进度最深的那条记录(见下方第8节)。

## 进度迁移(此前已人工发信的情况)

业务员在本系统上线之前,很可能已经用其他方式给部分客户手动发过1-2封信了。如果把所有人都当成全新客户处理,会造成重复的"第一封"信,体验明显穿帮。按以下快照逻辑迁移:

| 此前状态 | Migration action |
|---|---|
| 该步骤已发出 | 在新系统中标记为 `sent`,原样保留,**绝不重发**。 |
| 已计划但未发出 | 转入新系统为 `pending`,从此处续发。 |
| 已回复或已被人工停止跟进 | 直接加入 `suppression`。 |
| 跨来源重复 | 保留进度最深的那条记录。 |
| 进度规范化 | 每个序列应只有"下一个未发步骤"带有排期时间;下一步只在当前步骤实际发出后才排期。 |

**运行迁移前**:先备份数据库(对应 `03-development-sop.md` 铁律16)。

**迁移完成后**:产出对账报告 — `迁入数 + 新客数 == 总数`。人工抽查5个迁移客户,确认每个的"下一步该发什么"都正确。

## 报表差异

每日日报(P6)中,`reactivation` 模式下调整以下列:

- `assigned_rep` = `owner` 的姓名
- `source_channel` = `"reactivation"`(区别于冷开发模式使用的名单来源)
- `customer_code` = CRM参考编号,用于把回复对回CRM系统
- `lead_type` = `"company"` 或 `"personal"`,根据邮箱域名是否为个人邮箱服务商判断

## 构建清单

启动本模式时给Agent的一句话总需求(数字/名称按实际业务调整):

> "在现有cold_outreach流水线基础上叠加reactivation模式,独立部署互不干扰:①名单增加inquiry_summary/owner/customer_code字段;按业务员分别导入源文件,owner=源文件名,跨文件按邮箱去重;②写信prompt切换为上述重新联系规则(历史为空时不编造是铁律);③每个客户固定从其owner的邮箱发送;序列节奏+3/+7天;不需要热身,但要对共用同一发送域名的邮箱设置合计日发送量上限;④按快照规则迁移已有的人工发信进度,先备份、迁移后对账;⑤按上述规定调整日报列。全程用dry-run验证后再上线。"

## 验收清单

- 跨业务员去重完成 — 每个客户只有唯一的owner。
- 样本审核确认:有`inquiry_summary`的客户自然引用了历史;没有的客户没有编造历史(专门抽查空历史的样本)。
- 迁移对账报告数字平衡;抽查5个迁移客户的"下一步"均正确。
- 手动测试回复确认停发生效,且日报归属到了正确的owner。
- 共用发送域名的合计日发送量在配置的安全阈值以内。
05-security-compliance-guardrails.md — 密钥管理、法律合规基线、开源前检查清单
# 安全、合规与开源前防护规则

## 密钥管理

| 规则 |
|---|
| 所有凭证(ESP密钥、IMAP密码、LLM API key、VPS SSH密钥)只存在于 `.env`。 |
| `.gitignore` 排除 `.env`、`deploy/.env`、`data/*.db`、`data/backups/` — 在**第一次提交之前**就要设置好,不是事后补。 |
| 提交一份 `.env.example`,列出每个必需的key名称和占位符值,让仓库能说明需要什么但不暴露任何真实内容。 |
| 代码只通过环境变量读取凭证 — 绝不硬编码密钥,哪怕只是"临时"这样做。 |
| 在把任何仓库设为公开之前,对**完整git历史**(不只是当前工作区)运行密钥扫描工具(如 `gitleaks`、`trufflehog`)。 |
| 如果历史中任何时刻曾提交过密钥,发布前必须先轮换该凭证,并重写/压缩git历史将其彻底移除 — 不能只靠后续提交删除文件了事(历史记录仍能查到)。 |
| 如果本项目源自一次真实的生产环境部署,即使自认为没有提交过密钥,也应轮换该实例曾使用过的每一个凭证。 |

## 公开仓库中绝不能出现的内容

- 示例中的真实域名、公司名、品牌名 — 一律用 `yourcompany.com`、`Example Corp` 等占位符。
- 示例文件、fixture、测试数据中的真实客户/名单数据(邮箱、姓名、公司)— 使用明确标注为虚构的合成示例数据。
- 真实生产环境统计数据(实际发送量、实际名单量、实际回复率)— 改用示意性区间,或直接省略。
- 内部基础设施细节(真实VPS主机名/IP、内部SSH配置、内部文件服务器路径)。
- 任何员工姓名、内部团队结构或可识别组织架构的细节。

## 法律合规基线

以下为一般性指引,非法律意见 — 具体面向哪些司法管辖区发信,请咨询专业法律顾问。

| 要求 | Where it's implemented in this SOP |
|---|---|
| 标题和发件人身份真实、不具欺骗性 | `03-development-sop.md` P3 copy rules |
| 每封邮件都包含可用的退订机制 | Part A Rule 19; `List-Unsubscribe` header + body link |
| 及时且永久地尊重退订请求 | `suppression` table, "no resurrection" rule |
| 不得将邮件伪装成非商业/销售性质的通信 | Copy rules ban deceptive framing |
| 在有此要求的地区(如美国CAN-SPAM法案),须包含真实邮寄地址 | Add to the appended signature template |
| 面向欧盟/欧洲经济区发信时,评估B2B外发邮件在GDPR下的合法依据(B2B通常依据"合法利益",但有前提条件),并尊重数据主体的权利请求 | Business/legal decision — flag to the operator, not resolved by code alone |
| 面向加拿大发信时,注意CASL对"事先同意"的要求比CAN-SPAM的"选择退出"模式更严格 | Business/legal decision — flag to the operator |

## 代码库中的数据隐私

- 不要把第三方邮件正文全文记录到任何共享、公开或长期保留的日志目的地。
- 文档、README或issue中使用的示例输出必须用合成数据,不能用真实名单/客户数据 — 即使打了马赛克,真实数据也可能泄露模式信息。
- `suppression` 名单本身包含PII(退订者的邮箱地址)— 数据库备份应和其他PII存储一样谨慎处理;绝不能提交到仓库中。

## AI生成内容治理

- 每次批量扩大规模前,都要有人工审核样本并留下书面确认记录(对应`03-development-sop.md`铁律13)。
- 禁止编造规则(铁律12,及`04-reactivation-variant-spec.md`第3节中更严格的reactivation版本)既要写入系统提示词,**也要**由人工抽查验证 — 仅靠prompt指令不够可靠;批量生成时模型确实会出现不遵守指令的情况。
- 写信规则(匹配逻辑、禁用词、标题公式等)应作为结构化配置/prompt文件纳入仓库版本控制,而不是留存在某人脑中的非正式经验。

## 发布前检查清单(在仓库公开前立即执行一次)

- 对完整git历史进行密钥扫描 — 零发现,或所有发现均已通过重写历史+轮换凭证处理。
- 手动grep检查整个仓库(含提交信息)中是否残留真实公司域名、品牌名、员工姓名。
- 仓库中所有 `.env` 类文件都只含占位符。
- 确认示例/fixture数据均为合成数据。
- 已添加许可证文件(根据预期的复用方式选择合适的许可证)。
- README明确说明这是一个通用模板,使用者需要在使用前配置自己的域名、账号和产品目录。
06-troubleshooting-reference.md — 故障排查速查表(源自真实生产事故)
# 故障排查速查表

症状→根因→解法速查表。当操作者反馈异常时,先查表,再展开排查,不要凭空猜测。

## A. 送达率类

### A1. ESP显示已送达,但收件人看不到

- **根因**:DKIM缺失或配置错误。认证失败会悄悄降低送达率,不会在任何地方报错。
- **解法**:对每个发送域名逐一用DNS查询工具验证SPF/DKIM/DMARC。给Gmail/Outlook发自测邮件,检查认证结果邮件头确认通过,而不只是看"已发送"。
- **教训**"发送成功"不等于"被看到"。上线前务必用真实收件箱验证落地位置,不能只信ESP的送达状态。

### A2. ESP账户级限流/观察期

- **症状**:发送突然报403/观察期错误;账户下所有域名同时瘫痪约一小时。
- **根因**:新ESP账户通常有上限(如每域名每小时约100封)直到建立信任;**任何**共用该ESP账户的系统产生的发送量都会计入上限。
- **解法**:确保调度器自身的限速(热身+单邮箱日限额)明显低于ESP的上限;避免让不相关的系统共用同一个ESP账户;建立起合法使用记录后联系ESP客服解除观察期限制。

### A3. 邮件落入"促销"标签页

- **根因**:标题读起来像促销广告。
- **解法**:强制执行标题公式(产品词+场景词+公司名);禁用促销词、特殊符号、全大写。见 `03-development-sop.md` P3。

## B. 调度类

### B1. 调度器几乎不发信(计划60封/天,实际只发出寥寥几封)

- **根因**:同公司排期冲突时,错误地推进了整个邮箱的日期游标,而不是只顺延冲突的那一个客户。几家联系人较多的大公司就能把整张计划表撑出数月。
- **解法**:按 `03-development-sop.md` 铁律8正确实现装箱算法 — 冲突只顺延这一个客户。

### B2. 个人邮箱(Gmail/Outlook)客户被排到几年之后

- **根因**"同公司每日限额"规则被错误地应用到了个人邮箱域名上,把上千个gmail.com联系人按每天一个的速度排队。
- **解法**:用 `PERSONAL_DOMAIN_WHITELIST` 让个人邮箱域名豁免同公司限流规则。
- **现已是P4阶段的强制验收项**:这个具体场景在此前一次实际部署中是上线后才暴露的。现在不允许再靠上线后发现 —— 见 `03-development-sop.md` P4验收标准中的"免费邮箱域名压力测试"。

### B3. dry-run污染了真实数据

- **症状**:dry-run跑完后,数据库中出现虚假的"已发送"记录,热身计数被虚高。
- **解法**:强制dry-run严格只读。在CI或验收步骤中加入明确的运行前/后数据库对比测试 — 绝不能不经测试就假设dry-run是安全的。
- **现已是P4阶段的强制验收项**:只在空闲数据库上做一次diff是不够的 —— 写入行为可能藏在某个空闲状态测试根本不会触发的条件分支里(如回复处理、冲突解决)。见 `03-development-sop.md` P4验收标准中的"多状态dry-run测试"。

## C. 数据类

### C1. 富化/CRM字段被填成了错误公司的数据

- **症状**:相当一部分"主营产品"等字段描述的是己方产品,而不是客户的 — 通常是富化流程中的bug导致的。
- **解法**:任何批量生成前强制随机抽查≥20行(见`02-lead-data-schema.md`第3节规则9)。发现污染就先停下重新核实源数据,不要硬着头皮继续生成。

### C2. 模糊关键词排除误删有效客户

- **示例**:按"公司名含'college'"排除,会误删一家名字里恰好含该词但并非教育机构的正常公司。
- **解法**:始终基于精确的结构化分类字段过滤(如 `category == "higher_education"`),绝不使用公司名的自由文本子串匹配。

### C3. 自动任务绕过了人工设定的分批节奏

- **症状**:操作者原本打算分批生成/发送以观察结果,但夜间定时任务一次性处理了剩余的全部名单。
- **解法**:给每个自动化触发器(如夜间自动为新客户生成邮件的任务)配置独立的、明确的单批数量上限,不依赖人工的分批节奏假设。在人工分批上线期间,禁用或限制该自动任务。

## D. 回复处理类

### D1. 工单系统自动回复被误判为真人回复

- **症状**:客户被错误地停发并加入黑名单,因为一封来自工单系统的自动确认信被当成了他们本人的回复。
- **解法**:在启用"回复即停发"逻辑之前,先实现`03-development-sop.md` P5中的三层自动回复判断规则(邮件头/发件人特征/主题特征)。

### D2. 历史邮件积压被误判为新回复

- **解法**:每个邮箱在首次真正轮询前运行一次 `--init-baseline`(P5)。只处理UID高于基线的邮件。

## E. 部署运维类

### E1. 两个docker-compose项目在同一主机上撞车

- **症状**:部署第二个项目导致第一个项目的容器消失。
- **根因**:两个compose文件都依赖默认的目录名项目名,二者撞车。
- **解法**:每个 `docker-compose.yml` 都显式设置 `name:`(对应`03-development-sop.md`铁律18)。

### E2. 长时间远程任务在SSH断线后被杀死

- **解法**:长时间任务(构建、批量生成)用 `nohup` 或进程管理器运行,日志写入文件。

### E3. 密钥被误提交到仓库

- **解法**:第一天、第一次提交之前就为 `.env` 和密钥设置好 `.gitignore`。如果密钥曾被提交过,在push到共享/公开远程仓库之前,先轮换凭证并重写git历史 — 见 `05-security-compliance-guardrails.md`。

## F. 与编码Agent协作类

### F1. Agent报告"完成"但业务逻辑有问题

- **解法**:绝不接受"能跑"作为验收标准。要求每个阶段按`03-development-sop.md`中该阶段的验收标准出具证据(样本文件、打印的计划表、对账统计、数据库对比)。"代码能跑"和"业务逻辑正确"是两回事。

### F2. 新会话中Agent对此前决策毫无记忆

- **解法**:按`03-development-sop.md` Part B维护三份文档。每次新会话开头都用"读取AGENTS.md和PROGRESS.md,接续下一阶段"。

### F3. AI在外发文案中编造事实

- **解法**:在系统提示词中强制执行禁止编造规则(`03-development-sop.md`铁律12),并在每次批量扩大规模前保留强制人工审核环节(铁律13)。即使规则看起来已经收敛稳定,也不要移除人工审核环节。
十一、真实项目中的关键经验
最后总结几条项目跑下来最值钱的经验,都是踩过坑才确认的。
1. 数据质量比模型重要
AI 不会修复错误数据,它只会放大错误。名单里混入一批无效邮箱,系统会忠实地给它们发送每一轮跟进,浪费发送额度还拖累域名信誉。上线之前把数据清洗当作一等公民对待,比换更强的模型划算得多。
2. 不要让 AI 完全自由执行
企业自动化必须有边界。AI 负责判断哪些客户值得联系,发送量、发送时间、失败重试这些由程序层控制,人保留最终审核权。Demo 里那种让 Agent 自己决定一切的演示看起来很酷,放进生产环境就是事故源。
3. 先小规模验证
不要第一轮就对着上万条名单全量发送。正确路径是测试、优化、再放量:先拿一小批名单跑通全流程,确认送达率、回复率和内容质量,再逐步放大。这个项目里每次扩量都伴随一轮发送参数调整,小规模验证是唯一不会翻车的节奏。
Pro Tip 实操技巧
正式放量前,用小批量名单做一轮完整演练:发信、收回复、看退信率、调内容。数据达标后再逐步提升每日上限,比一次性全量发送稳得多。
结语:AI Agent 真正改变的是业务流程
这套系统表面上看是邮件自动化,本质是企业获客流程的重新设计。过去企业买软件,买的是一个工具,数据散落在 CRM、Excel 和业务员脑子里;现在做 AI 落地,是把企业自己的数据、业务规则和工作流程,转化成一套可以长期运行的 AI 系统。
分工其实很清晰:AI 负责理解,程序负责执行,人负责创造价值。AI 判断客户值不值得联系,程序保证发送稳定合规,销售把精力留给真正有意向的对话。这才是企业 AI Agent 真正落地的方式,也是这套系统从设计到上线,最想验证的一件事。
每周四送达。
主机评测、建站对比、性能优化技巧和插件推荐 — 每周为 WordPress 站长和建站者精选。