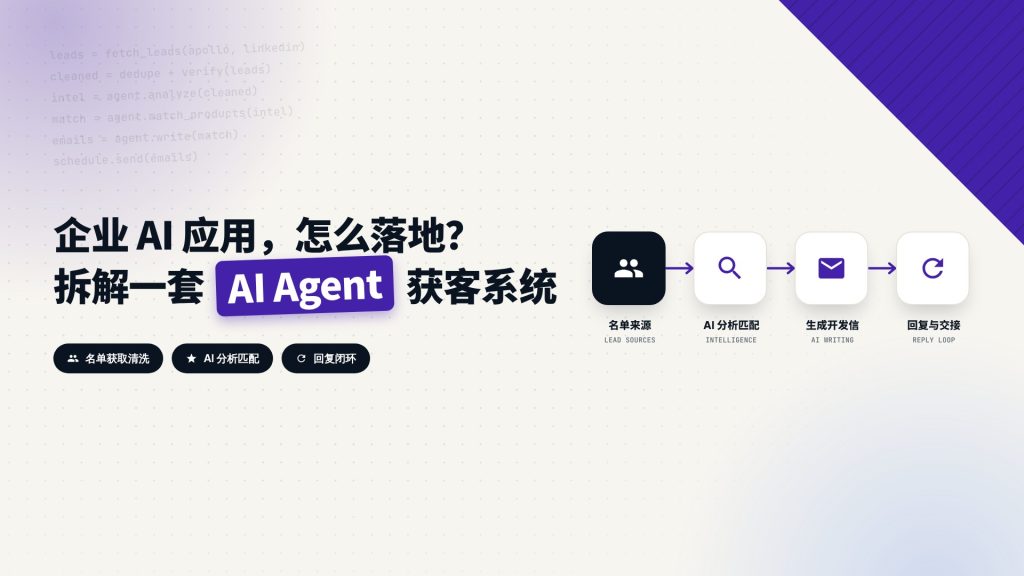
这篇文章拆解一套 AI Agent 驱动的自动化获客系统从设计到落地的全过程:名单获取与清洗、企业知识库、AI 客户分析与产品匹配、邮件生成与发送基础设施、回复闭环,以及用 Codex 和 Claude Code 交付复杂 AI 系统的方法与关键经验。
为什么企业需要重新思考获客流程?
过去几年,大量企业开始积累自己的数字资产:CRM 客户数据、历史询盘、展会名单、网站访客、产品资料。这些数据真实存在,却没有自动转化为业务机会。另一边,新客户开发仍然高度依赖人工:搜索目标企业、研究客户背景、找联系人、写开发邮件、跟进回复,每一步都靠人肉完成。
企业获客因此卡在两个效率瓶颈上:存量客户不知道怎么激活,增量客户找不到持续的精准来源。这篇文章记录的是我们设计的一套 AI Agent 驱动的自动化获客系统,目标不是做一个自动群发工具,而是让 AI 参与整个销售开发流程,把上面两条路径都变成可运行的管道。
一、系统目标与整体架构
这套系统的定位是一条完整的外联管道:Lead Generation + Customer Intelligence + Outreach Automation Pipeline,也就是线索获取、客户情报和外联自动化三个能力合在一起。线索从名单来源进入系统,经过清洗、分析、产品匹配,最后落到邮件生成、发送调度和回复跟踪,全程不需要销售手动搬运数据。
整体流程可以画成八个环节:
整体流程:从名单到销售交接
Lead Sources
多渠道名单来源
→
Data Processing
去重、验证、清洗
→
Customer Intelligence
AI 分析客户业务
→
Product Matching
判断可能的采购需求
AI Content Generation
批量生成开发信
→
Email Scheduling
限速与发送窗口
→
Reply Detection
IMAP 轮询回复
→
CRM / Sales Handoff
转入人工跟进
从工程上看,这八个环节可以归纳成五层:数据采集层负责把名单收进来,数据处理层负责清洗和富化,AI 推理层负责分析客户和生成内容,自动执行层负责调度、发送和状态管理,反馈闭环层负责把回复和退信送回系统。后面几节会按这个顺序展开每一层怎么设计。
二、潜在客户数据获取:从人工搜索到自动化名单生成
1. 为什么数据获取是第一步?
很多人以为 AI 获客的第一步是写邮件,实际恰恰相反,第一步永远是找到正确的人。如果输入的数据是错的,AI 生成能力越强,错误规模就越大:系统会给不相关的公司发三千封精心写好的开发信,每一封都精准命中错误对象。所以整套系统最先要建立的不是写信能力,而是 Lead Pipeline,一条干净的、可扩充的名单管道。
2. 自动化客户搜索
新客户开发的名单来源有几条路:Apollo 这类 B2B 联系人数据库、LinkedIn Sales Navigator、Serper 和 Google Search API 这类搜索接口,以及针对特定行业自建的爬虫。这个项目里 Apollo 是名单主来源,再叠加其他渠道补充。
推荐阅读:把 Apollo 邮件营销从注册配到自动发信,完整步骤在这里。
搜索不是拿一个关键词漫天撒网,而是用结构化条件圈定目标,通常组合五个维度:
- Country 目标市场国家
- Industry 所属行业
- Company Size 公司规模
- Job Title 联系人职位
- Keyword 业务关键词
举个例子,一家做汽车改装件的企业想开发美国市场的采购客户,筛选条件大概是这样:
| 筛选维度 | 取值 |
|---|---|
| Country | United States |
| Industry | Automotive Aftermarket |
| Job Title | Purchasing Manager / Engineering Manager / Owner |
跑完搜索,系统拿到的不只是邮箱地址,而是完整的联系人记录:公司名称、官网、联系人姓名、职位、Email、LinkedIn 主页。这些字段后面都会变成 AI 分析客户的输入,所以这一步宁可多抓几个字段,也不要只存一个邮箱。
3. 老客户名单从哪里来
上面的搜索流程解决的是新客户来源,老客户线索在系统里是另一条完全独立的管道,源头不在外部渠道,而在 CRM 的存量数据里。所谓沉睡客户,通常指两类人:曾经来咨询过、报过价但一直没成交的,以及成交过一两次、之后很长时间没有继续复购的。这些客户不需要搜索和筛选,他们已经躺在系统里,问题是怎么重新激活。
沉睡客户的名单富化比新客户多一项关键内容:除了公司、联系人、行业这些基础字段,每一行还必须带上曾经的交易和沟通记录。最理想的状态是完整的时间线记录,能还原每一次咨询、报价、成交和后续沟通的先后顺序;如果 CRM 里的数据做不到这么细,至少要整理出一条过往记录摘要,把关键事实浓缩进去:客户问过什么产品、报价多少、最后卡在哪一步、成交过什么、大概什么周期采购。没有这些信息,后面的 AI 分析和邮件生成都无从下手。
4. 数据清洗与富化
原始名单不能直接喂给 AI,中间必须过一遍清洗。去重是为了避免同一个客户被重复触达,邮箱验证用来过滤无效邮箱、info 这类通用邮箱和高风险邮箱,剩下的记录还要补上公司信息:通过官网、Serper API 或企业数据库,把公司主营、产品方向、行业这些背景字段填完整。老客户记录在清洗时还要单独核对交互历史字段,确保每一条都带着时间线或过往摘要进入下一步。
清洗和富化完成后,每一条记录变成结构化的 Lead Database,大概是下面这个形状:
{
  "company": "Motorsport Suspension Manufacturer",
  "contact": "purchasing@example.com",
  "industry": "Automotive Aftermarket",
  "country": "United States",
  "website": "https://example.com",
  "business_summary": "Designs and builds suspension systems for motorsport and performance vehicles",
  "potential_products": ["Rod Ends", "Spherical Bearings", "Linkage Components"]
}
三、给 AI Agent 建立企业知识库:像培训新员工一样培训 AI
这一节是整套系统里最重要的设计之一。很多人用 AI 做业务失败,原因不是模型不够强,而是 AI 根本不知道你的业务:不知道公司卖什么、优势在哪、什么客户不能接。指望模型凭通用知识替你写开发信,等于让一个没参加过培训的新销售直接去谈客户。
1. 不直接 Prompt,而是建立 Business Context
我们的做法是先准备一份企业知识文档 company-profile.md,把销售需要知道的业务背景全部结构化写进去:公司介绍(成立时间、企业定位、生产能力、服务市场),产品资料(产品分类、技术参数、应用场景),认证资质(ISO、RoHS、SGS 等),客户案例(服务行业、应用案例、合作模式),还有商业规则(MOQ、Lead Time、Payment Terms、Sales Style)。
| 知识板块 | 包含内容 |
|---|---|
| 公司介绍 | 成立时间、企业定位、生产能力、服务市场 |
| 产品资料 | 产品分类、技术参数、应用场景 |
| 认证资质 | ISO、RoHS、SGS、行业认证 |
| 客户案例 | 服务行业、应用案例、合作模式 |
| 商业规则 | MOQ、Lead Time、Payment Terms、Sales Style |
这个过程实际上是在给 AI Agent 做一次入职培训。新销售入职不会第一天就去联系客户,他会先搞清楚三件事:公司是谁、卖什么、优势是什么。AI Agent 也一样,prompt 写得再好,都不如让它先把 company-profile.md 读完,再开始碰客户数据。
Key Takeaway 核心结论
AI Agent 的能力上限由它对业务的了解程度决定。先建立企业知识库,再谈 Prompt,是这套系统能落地的第一前提。
四、AI 客户分析与产品匹配
从“生成邮件”升级到“销售判断”
传统邮件自动化的逻辑是套模板:Customer Name 加一个 Template,等于一封邮件,换的只是抬头和公司名。AI 系统的输入完全不同,它拿到的是客户业务、行业、产品应用场景和企业知识库,输出也不是一封邮件,而是一条外联策略:这个客户值不值得联系、可能需要什么产品、第一封信用什么角度切入。
| 对比项 | 传统邮件自动化 | AI 系统 |
|---|---|---|
| 输入 | 客户姓名 + 固定模板 | 客户业务 + 行业 + 产品应用 + 企业知识库 |
| 输出 | 一封套模板邮件 | 外联策略(含推荐产品与切入角度) |
| 客户粒度 | 汽车行业客户 | 具体到可能的采购品类 |
| 核心问题 | 我们想卖什么? | 客户为什么可能需要我们? |
用项目里一个真实场景说明。客户是一家 Motorsport Suspension Manufacturer,也就是赛车悬挂系统制造商。AI 分析完它的业务和产品后,推断出的潜在需求不是笼统的“汽车行业客户”,而是 Rod Ends、Spherical Bearings、Linkage Components 这些具体的悬挂连接件品类,然后针对这些品类写开发信。
老客户的分析要在新客户这套逻辑上多一层输入:历史记录。对新客户,AI 看到的是公司业务和可能的需求;对老客户,AI 拿到的还有完整的交易与沟通时间线,或者至少一份过往记录摘要,分析的问题也随之改变。新客户要回答的是“他需不需要我们的产品”,老客户要回答的是“上次为什么没谈成,这次有什么新机会能重新打开话题”,或者是“他买过一次之后为什么停了,现在是不是到了复购窗口”。同样是推荐产品,老客户的推荐要建立在历史采购品类之上,而不是从零推断。
这套判断的核心逻辑只有一句话:不是“我们想卖什么”,而是“客户为什么可能需要我们”。想清楚这一点,AI 写出来的内容才有相关性,邮件才不会一进收件箱就被当成垃圾营销。
五、核心架构设计:AI 负责判断,程序负责执行
这是企业级 AI 系统和普通 Agent Demo 最大的区别。很多 Demo 让 Agent 自主执行所有事情,看起来聪明,但生产环境不能这么干:它会自己决定发送节奏,自己改数据,出了问题没人知道在哪一步。企业系统需要控制,所以架构上把系统切成两层。
AI Layer 负责需要理解力的工作:理解客户、给客户分类、做产品匹配、生成邮件内容、分析回复。这一层可以按任务切换模型,比如用 Claude 或 GPT 做复杂推理,用 DeepSeek 跑批量生成。
Execution Layer 负责确定性工作:调度、API 调用、状态管理、数据写入、邮件发送,这一层用 Python 的 Scheduler、Worker 和 Database 实现,逻辑必须完全可预期。
| 对比项 | AI Layer | Execution Layer |
|---|---|---|
| 职责 | 理解客户、分类、产品匹配、生成内容、回复分析 | 调度、API 调用、状态管理、数据写入、邮件发送 |
| 实现 | Claude / GPT / DeepSeek | Python Scheduler / Worker / Database |
| 特质 | 需要灵活 | 需要确定 |
| 决策边界 | 可以判断“这个客户值得联系” | 决定“今天发多少封、什么时间发” |
为什么这样切?因为 AI 擅长的是开放问题,业务系统需要的是确定性。AI 可以判断“这个客户值得联系”,但不能决定“今天发送 500 封邮件”。发送量、发送时间、失败重试这些硬约束必须由程序层执行,AI 只负责在边界内做判断,这是整套系统稳定运行的基础。
六、邮件生成系统设计
1. AI 离线生成,而不是实时生成
常见的错误设计是发送时实时调用 AI:发一封,调一次模型,再发下一封。生产环境不推荐这么做,响应慢、成本不可控,而且内容完全没有审核机会。我们采用的是离线批量生成:名单先统一过一遍 AI,生成结果进入人工审核,审核通过才进发送队列。
邮件生成链路:先批量生成,再人工审核
Lead Database
清洗后的名单
→
Batch AI Generation
统一批量生成
→
Human Review
抽检与修改
→
Sending Queue
进入发送队列
离线批量生成带来的四个好处正好对应生产环境的诉求:内容可审核,销售负责人能在发送前看到每一封信;可修改,发现口径不对可以整批调整再放行;成本低,批量调用模型比逐封实时调用便宜得多;系统稳定,发送流程不依赖模型接口的实时可用性。
2. 邮件生成规则
开发信的生成规则在系统里是写死的约束:纯文本格式、内容短、单一 CTA、不用营销词。纯文本和短内容是为了送达率和可读性,单一 CTA 让收件人只做一件事,不用营销词是为了避免触发垃圾邮件过滤。
每次生成时,AI 的输入是三条:Customer Profile(客户档案)、Company Knowledge(企业知识库)、Product Match(产品匹配结果);如果目标是老客户,还会追加一条 Interaction History(历史交易与沟通记录)。输出则包含四部分:Subject、Body、Reasoning 和 Recommended Product。Reasoning 是这条记录里 AI 判断客户值得联系的推理过程,Recommended Product 是它推荐主推的产品。这两列不是给收件人看的,是给人工审核和后续分析用的。
针对老客户的邮件,生成规则要加一条硬约束:正文必须引用具体的过往记录。线下销售跟进老客户时,开口永远是“您去年采购过我们的 Rod Ends,最近使用情况怎么样”,或者“您之前咨询过我们的悬挂连接件,不知道现在是否还在考虑”,不会把对方当陌生人重新自我介绍。AI 生成老客户邮件也是一样,要基于 Interaction History 提到采购过的产品、咨询过的问题或者上次沟通停在哪一步,收件人才会意识到这封信是专门写给他的,而不是批量群发。
七、邮件基础设施设计
冷邮件系统最容易失败的地方不是 AI,而是发送基础设施。内容写得再好,进不了收件箱等于零,而进垃圾箱只需要一次错误的配置。
工具架构
| 组件 | 用途 |
|---|---|
| Mailgun | 邮件发送 API |
| IMAP | 读取回复邮件 |
| SPF / DKIM / DMARC | 域名认证,进收件箱的前提 |
| Dedicated Domain(专用域名) | 隔离发信域名,保护主域名信誉 |
| VPS | 让系统 24 小时长期运行 |
邮件协议和送达验证是两个容易踩坑的点。IMAP、POP、SMTP 各自负责什么,决定了邮件客户端怎么收发信,这套系统的回复检测就依赖 IMAP 读取,可以看这篇 什么是 IMAP、POP、SMTP;正式发信前,最好先给测试邮箱发一封验证信,确认不会进垃圾箱再放量,判断方法在这篇 我靠 Gmail Authentication-Results 判断测试信会不会进垃圾箱 里。
这套架构里最值得说的一点是专用域名。发信域名和主域名分开,即使发信域名被邮件服务商标记,也不会拖累官网邮箱。SPF、DKIM、DMARC 三条 DNS 记录在发信前就必须配好,具体配置方法可以看我们写的这篇 SPF、DKIM、DMARC 配置教程。
邮箱信誉控制
新邮箱直接满负荷发送,基本等于自杀。信誉控制是发送调度层最重要的设计,四个参数缺一不可:Warm-up(逐步提高发送量)、Sending Limit(每日上限)、Random Interval(发送间隔随机化)、Time Zone Delivery(按收件人当地时间发送)。
上面这些参数约束的都是单个邮箱账号。如果业务需要每天发出几百封,正确做法不是拉高单个账号的上限,而是横向扩展:配置多个不同子域名的邮箱账号,比如 mail1.example.com、mail2.example.com 各自建一个发件邮箱。每个账号仍然从自己的热身阶梯开始,分别遵守每日上限和随机间隔,子域名之间的信誉相互隔离,即使某一个账号被邮件服务商标记,也不会拖累主域名和其他账号,系统的总发送量靠账号数量叠加上去。
新邮箱的发送量按天阶梯上升,项目里用的是下面这个节奏:
| 阶段 | 每日发送上限 |
|---|---|
| Day 1 – 3 | 10 封 / 天 |
| Day 4 – 7 | 20 封 / 天 |
| Day 8 – 12 | 35 封 / 天 |
| Day 13 之后 | 50 封 / 天 |
风险提示 Warning
邮箱热身阶段不能跳级。新邮箱第一天就发几百封,域名信誉会立刻被邮件服务商标记,后面再想恢复要付出几倍的代价。
八、回复闭环设计
发送不是终点,回复才是。一封开发信发出去之后,系统必须能回答三个问题:这是真人回复、自动回复还是退信?
回复处理闭环
Email Sent
开发信已发出
→
IMAP Monitoring
轮询收件箱
→
Reply Classification
AI 判断回复类型
Stop Sequence
停止后续跟进
→
CRM Update
状态回写系统
→
Sales Follow-up
销售接手跟进
回复分类由 AI Layer 处理:检测到真人回复,立刻停止这条线索的后续跟进序列,并把状态更新到 CRM,交给销售接手;检测到自动回复(比如 out-of-office),继续序列,等对方回来再跟进;检测到退信,把地址放进 Suppression List,系统以后不再向这个地址发送任何邮件。
九、技术栈与成本
整套系统的技术栈没有用冷门框架,全部是成熟组件,按用途分四块:
| 类别 | 工具 | 在这个系统里的分工 |
|---|---|---|
| AI 开发工具 | Claude Code / Codex | 架构设计、代码生成、Debug、部署 |
| AI 模型 | Claude Opus | 系统设计、复杂推理 |
| AI 模型 | DeepSeek | 批量邮件生成、大规模任务 |
| 数据工具 | Apollo | 客户名单获取 |
| 数据工具 | Serper API | 企业信息补充 |
| 邮件服务 | Mailgun | SMTP / API 发送、Tracking、Bounce 处理 |
| 部署 | VPS + Docker | 长期运行、环境隔离 |
开发这整套系统,核心开发工作由 AI 编码工具完成:用 Claude Code 或 Codex 做架构设计、生成代码和调试,开发者负责拆任务、写约束和验收结果。模型选择上按任务分级,复杂推理用 Claude Opus,跑批量邮件生成这类大规模任务用 DeepSeek,成本能压到很低。
把 Claude Code 和 Codex 当主力开发工具,订阅和账号稳定性是前提。付款方式上,没有信用卡也能订阅,具体做法可以看这篇 无需信用卡,也可以订阅 ChatGPT 和 Claude Code;账号长期高强度使用存在被风控的风险,怎么规避可以参考这篇 如何降低 Claude Code 账号异常风险。
跑系统本身不需要昂贵的机器,一台 2 Core、2GB 内存、Ubuntu 24.04 的 VPS 加 Docker 就够了,这类长期运行的项目,Hostinger 的 VPS 从配置到价格都比较合适。
十、Agent 项目开发方法:如何让 Codex 和 Claude Code 完成复杂系统
这种规模的系统,不能指望丢一句“帮我做一个邮件系统”就让 AI 写完。大型 AI 开发项目的正确打开方式,是先建立一套项目文档,让 Agent 拥有长期上下文。项目目录一开始就是固定的结构:
project/
├── BRAINSTORMING.md
├── PLAN.md
├── CLAUDE.md
├── PROGRESS.md
├── TODO.md
└── .env
| 文件 | 记录什么 |
|---|---|
| BRAINSTORMING.md | 业务目标,为什么要做这套系统 |
| PLAN.md | 开发计划,按什么顺序推进 |
| CLAUDE.md | 项目规则,Agent 必须遵守的约束 |
| PROGRESS.md | 当前状态,做到哪一步了 |
| TODO.md | 待办事项,下一步要做什么 |
| .env | 环境变量与密钥,不进入版本库 |
这几份文档的价值在于,每次新开会话,Agent 读一遍 PROJECT 状态就能接着上次的进度干活,不需要从零回忆。尤其是 CLAUDE.md,把前面几节讲的红线(发送节奏、人工审核、禁止 AI 自主决定发送量)写成项目规则,Agent 在开发过程中就会自动遵守。
十一、真实项目中的关键经验
最后总结几条项目跑下来最值钱的经验,都是踩过坑才确认的。
1. 数据质量比模型重要
AI 不会修复错误数据,它只会放大错误。名单里混入一批无效邮箱,系统会忠实地给它们发送每一轮跟进,浪费发送额度还拖累域名信誉。上线之前把数据清洗当作一等公民对待,比换更强的模型划算得多。
2. 不要让 AI 完全自由执行
企业自动化必须有边界。AI 负责判断哪些客户值得联系,发送量、发送时间、失败重试这些由程序层控制,人保留最终审核权。Demo 里那种让 Agent 自己决定一切的演示看起来很酷,放进生产环境就是事故源。
3. 先小规模验证
不要第一轮就对着上万条名单全量发送。正确路径是测试、优化、再放量:先拿一小批名单跑通全流程,确认送达率、回复率和内容质量,再逐步放大。这个项目里每次扩量都伴随一轮发送参数调整,小规模验证是唯一不会翻车的节奏。
Pro Tip 实操技巧
正式放量前,用小批量名单做一轮完整演练:发信、收回复、看退信率、调内容。数据达标后再逐步提升每日上限,比一次性全量发送稳得多。
结语:AI Agent 真正改变的是业务流程
这套系统表面上看是邮件自动化,本质是企业获客流程的重新设计。过去企业买软件,买的是一个工具,数据散落在 CRM、Excel 和业务员脑子里;现在做 AI 落地,是把企业自己的数据、业务规则和工作流程,转化成一套可以长期运行的 AI 系统。
分工其实很清晰:AI 负责理解,程序负责执行,人负责创造价值。AI 判断客户值不值得联系,程序保证发送稳定合规,销售把精力留给真正有意向的对话。这才是企业 AI Agent 真正落地的方式,也是这套系统从设计到上线,最想验证的一件事。
每周四送达。
主机评测、建站对比、性能优化技巧和插件推荐 — 每周为 WordPress 站长和建站者精选。